













ShadowRayは、Ray人工知能(AI)フレームワークのインフラが露出した問題だ。この露出は現在も攻撃を受けているが、Ray側はこれを脆弱性だと認めず、修正する予定もない。Rayの開発者とセキュリティ研究者の対立は、隠れた前提を浮き彫りにするとともに、ShadowRayを通じてAIセキュリティ、インターネットに露出した資産、脆弱性スキャンについての教訓を示している。
ShadowRayとは
AIコンピューティングプラットフォームのAnyscaleは、主にAIワークロードの管理に使われるオープンソースのRay AIフレームワークを開発した。このツールの顧客には、DoorDash、LinkedIn、Netflix、OpenAI、Uberなど多数の企業が名を連ねる。
セキュリティ研究者であるOligo SecurityはCVE-2023-48022を発見し、ShadowRayと名付けた。この脆弱性は、RayがJobs APIで認可を適用していないことを示している。そのため、ダッシュボードのネットワークにアクセスできる認証されていないユーザーなら誰でも、ジョブの起動や、ホスト上での任意コード実行まで可能になる。
研究者らは、この脆弱性を共通脆弱性評価システム(CVSS)で10点満点中9.8と評価すべきだと算定している。しかしAnyscaleは、この露出を脆弱性だと認めていない。Rayは管理された環境内でのみ使用することを想定しており、認可がないのは意図された仕様だと主張している。
ShadowRayによる被害
残念ながら、多くの顧客は、環境がインターネットに露出しないというAnyscaleの前提を理解していないようだ。Oligoはすでに、攻撃者によって侵害された露出サーバーを数百台検出し、侵害の種類を次のように分類している。
- アクセスされたSSH鍵:攻撃者がホスティング環境内の他の仮想マシンに接続し、永続化を実現したり、コンピューティングリソースを別の目的に転用したりできる。
- 過剰なアクセス:組み込まれたAPI管理者権限により、RayのrootアクセスやKubernetesクラスターを介して、攻撃者がクラウド環境にアクセスできる。
- 侵害されたAIワークロード:AIモデルの結果の完全性に影響を与え、モデルを窃取したり、モデルのトレーニングに不正なデータを混入して将来の結果を改変したりできる。
- 乗っ取られたコンピューティングリソース:高価なAIコンピューティング能力を攻撃者の目的に転用する。主な用途は、盗んだリソースで暗号資産をマイニングするクリプトジャッキングだ。
- 窃取された認証情報:OpenAI、Slack、Stripe、社内データベース、AIデータベースなどの露出したパスワードを通じて、他のリソースも侵害にさらす。
- 奪取されたトークン:攻撃者が資金を盗み(Stripe)、AIサプライチェーン攻撃を実施し(OpenAI、Hugging Faceなど)、社内通信を傍受できる(Slack)。
社内のRayリソースが厳格なネットワークセキュリティ対策の背後で安全に保護されていることを確認していないなら、Anyscaleのツールを実行して今すぐ露出したリソースを特定してほしい。
ShadowRayが示す間接的な教訓
被害者にとって直接的な損害は甚大になるだろうが、ShadowRayは、クラウドやAIの導入を急ぐ中で見過ごされてきた、ネットワークセキュリティに関する隠れた前提を明らかにした。AIセキュリティ、インターネットに露出したリソース、脆弱性スキャンという観点から、これらの前提を検証してみよう。
AIセキュリティに関する教訓
AIが秘める力を活用しようと急ぐあまり、企業は取り組みをAI専門家に委ねる。AI専門家は当然、AIモデルの結果を得るという本来の目的に集中する。これは自然な視野狭窄だが、企業はShadowRayが浮き彫りにした3つの重要な隠れた問題を見落としている。AI専門家にはセキュリティの専門知識が不足していること、AIデータには暗号化が必要なこと、AIモデルにはソースの追跡が必要なことだ。
AI専門家にはセキュリティの専門知識が不足
Anyscaleは環境が安全だと想定しており、AI研究者もRayは安全だと想定している。Orca SecurityのフィールドCTOであるNeil Carpenter氏は、次のように指摘する。「エンドポイントを認証しないのであれば、少なくともデフォルトで、直近のサブネット外からのアクセスを遮断するネットワーク制御を設けるべきだ。このCVEを設計どおりのものだとして争うのではなく、対処に取り組まない著者の姿勢には失望している」
Anyscaleの回答とRayの実際の利用状況を照らし合わせると、AI専門家にはセキュリティの考え方が欠けていることが分かる。数百台のサーバーが露出していた事実は、多くの組織がAIチームにセキュリティ担当者を加えるか、運用にセキュリティ監督を組み込む必要があることを示している。安全なシステムだと思い込み続ける組織は、データコンプライアンス侵害などの被害を受けることになる。
AIデータには暗号化が必要
攻撃者は、暗号化されていない機密情報を容易に検出して見つけ出す。特にOligoの研究者が「モデルやデータセットは、競合他社との差別化要因となる、企業固有の非公開知的財産だ」と説明するデータが狙われる。
AIデータは、データ侵害や企業秘密の露出につながる単一障害点になる。それにもかかわらず、AI研究に数百万ドルを投じる組織は、それを守るために必要な関連セキュリティへの支出を怠っている。幸い、アプリケーション層暗号化(ALE)や、その他の最新の暗号化ソリューションを導入すれば、社内外のAIデータモデリングを保護できる。
AIモデルにはソースの追跡が必要
AIモデルがモデリングのために情報を取り込む際、AIプログラマーはすべてのデータが良質であり、「ゴミを入れればゴミが出る」という原則がAIには当てはまらないと考えがちだ。しかし、攻撃者がトレーニングデータセットに外部の偽情報を挿入できれば、モデルは影響を受け、結果が完全に歪められる可能性もある。それでもAIデータの保護は難しいままだ。
「これは急速に進化している分野だ」とCarpenter氏は認める。「しかし、既存の対策は、将来のAIトレーニング資料への攻撃を防ぐのに役立つ。例えば、第一の防御線には、IDとネットワーク層の両方でアクセスを制限することや、AIモデルのトレーニングに使うデータへのアクセスを監査することが含まれる。AIトレーニングを含むサプライチェーンの安全確保は、他のソフトウェアサプライチェーンと同じように、強固な基盤から始まる」
従来の防御策は社内のAIデータソースには有効だが、組織外のデータソースを取り込むと、はるかに複雑になる。Carpenter氏は、第三者のデータについては、「データの悪意ある汚染、著作権侵害、暗黙のバイアス」といった問題を避けるため、追加の検討が必要だと指摘する。こうした問題を避けるデータの洗浄は、AIモデルのトレーニング用サーバーにデータを追加する前に実施しなければならない。
研究者の中には、AIのハルシネーションさえも含め、あらゆる結果を妥当だと考える人がいるかもしれない。しかし、架空の結果や破損した結果は、その結果を現実世界で適用しようとする人を誤らせる。AIに影響を与えるデータの真正性、妥当性、適切な利用を追跡するには、プロセスに健全な懐疑心を取り入れる必要がある。
インターネットに露出したリソースに関する教訓
ShadowRayが問題となるのは、AIチームがインフラを一般公開したためだ。しかし、他にも多くの組織が、悪用可能な重大なセキュリティ脆弱性を開いたまま、リソースをインターネットからアクセス可能な状態にしている。例えば、下の画像はShadowserver Foundationがインターネットからアクセス可能だと検出した、数十万件のIPアドレスに存在する重大度「クリティカル」の脆弱性を示している。
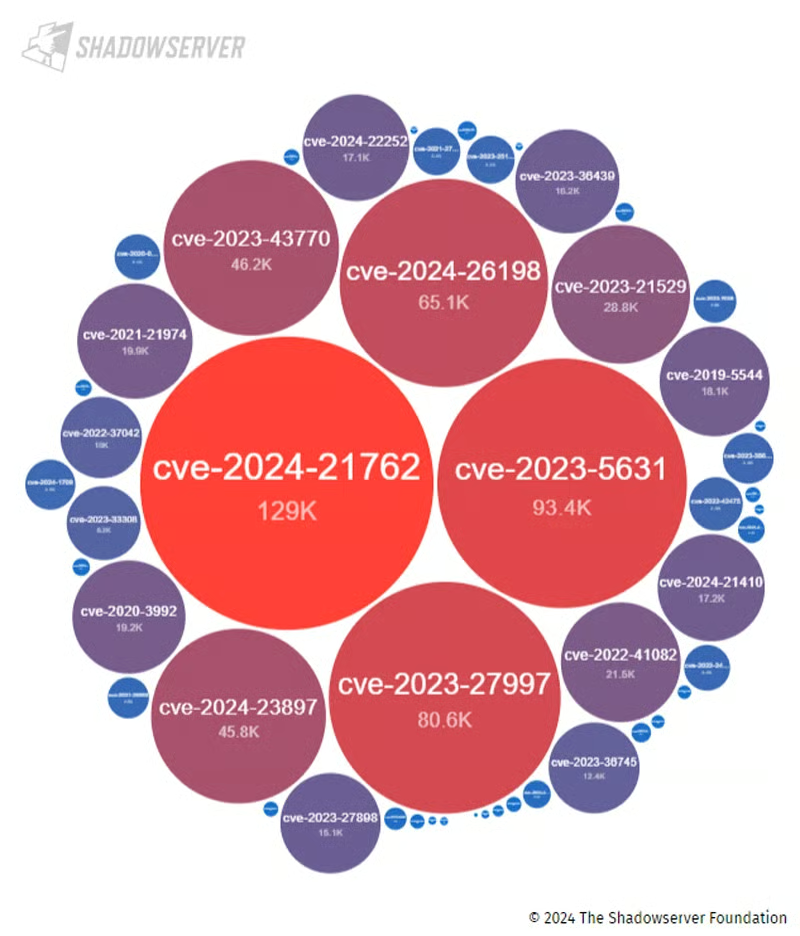
あらゆるレベルの脆弱性を検索すると、潜在的な問題は数百万件に上る。しかし、ShadowRayのように論争中のCVEや、設定ミスによって誤ってアクセス可能になったインフラさえ含まれていない。クラウドネイティブアプリケーション保護(CNAP)プラットフォームや、クラウドリソース脆弱性スキャナーを導入すれば、露出した脆弱性の検出に役立つ。
残念ながら、スキャンを実施するには、AI開発チームなどリソースを展開するチームが、追跡やスキャンのためにリソースをセキュリティ部門へ提出する必要がある。AIチームは予算や迅速な展開を理由に独自にリソースを立ち上げる可能性が高いが、セキュリティチームがインフラにクラウドセキュリティのベストプラクティスを適用するには、リソースの存在を把握していなければならない。
脆弱性スキャンに関する教訓
AnyscaleがCVE-2023-48022をめぐって争っていることで、この脆弱性は、他の多くの論争中のCVE脆弱性と同様、グレーゾーンに置かれている。こうした脆弱性には、まだ実証されていないため有効ではない可能性があるものや、製品が意図したとおりに動作しているものの、安全でない方式で動作するもの(ShadowRayなど)が含まれる。
こうした論争中の脆弱性は、脆弱性管理ツールまたはリスク管理プログラムを通じて追跡する価値がある。また、ShadowRayが示した2つの重要な教訓から、特別な注意も必要だ。第一に、脆弱性スキャンツールによって論争中の脆弱性の扱いは異なる。第二に、こうした脆弱性は積極的な追跡と検証を必要とする。
論争中の脆弱性の扱いの違いに注意する
脆弱性スキャナーや脅威フィードによって、論争中の脆弱性の扱いは異なる。論争中の脆弱性を除外するものもあれば、オプションのスキャン対象に含めるもの、別種の問題として扱うものもある。
例えばCarpenter氏は、「OrcaはこれをCVE形式の脆弱性ではなく、セキュリティ体制上のリスクとして対処する方針を取った。これは組織にとって、より扱いやすいアプローチだ。CVEは通常、アップデートで対処するものだが、今回はアップデートが提供されない。一方、体制上のリスクは設定変更で対処する。今回の問題には、それが正しいアプローチだ」と明かしている。ITチームは、特定のツールが特定の脆弱性をどう扱うのかを積極的に追跡する必要がある。
脆弱性を積極的に追跡・検証する
ツールはプロセスを簡単にすると約束するが、残念ながら、セキュリティに関する便利なボタンはまだ存在しない。脆弱性スキャナーについて言えば、既存のツールが特定の脆弱性をスキャンするかどうかは明白ではない。
セキュリティチームは、IT環境に影響を及ぼす可能性のある脆弱性を積極的に把握し、懸念される特定のCVEをツールがチェックするか検証しなければならない。論争中の脆弱性については、脆弱性スキャナーのサポートチームに問い合わせ、そのツールが当該脆弱性にどう対処するのか、または対処しないのかを確認するなど、追加の手順が必要になる場合がある。
露出のリスクをさらに減らすには、複数の脆弱性スキャンツールとペネトレーションテストを使って、発見された脆弱性がもたらす潜在的なリスクを検証するか、さらに潜在的な問題を見つけるとよい。ShadowRayの場合、Anyscaleは1つのツールを提供したが、無償のオープンソースの脆弱性スキャンツールも有用な追加リソースを提供できる。
結論:重大な脆弱性はチェックと再チェックを
ShadowRayに対して脆弱でなくても、AIのリスク、インターネットに露出した資産、脆弱性スキャンについてこの問題が示す間接的な教訓を理解することはできる。実際の被害は深刻だが、重要なインフラの潜在的な脆弱性を継続的にスキャンすれば、攻撃者が被害をもたらす前に対処すべき問題を見つけられる。
脆弱性スキャンツール、AIモデリング、クラウドリソースの展開を急ぐ従業員には限界があることを認識しよう。チームが連携してセキュリティを高める仕組みを構築し、調査、脅威フィード、脆弱性スキャナー、ペネトレーションテストを通じて潜在的な脆弱性を継続的に監視する体制を導入する必要がある。
詳しくは脅威インテリジェンスフィードについて読むことを検討してほしい。