

















Sécurité des infrastructures critiques s’est placée au premier plan des préoccupations en matière de cybersécurité dans le contexte de l’invasion russe de l’Ukraine – et a, dans au moins un cas, donné lieu à des conseils de cybersécurité pour le moins originaux.
Malgré l’échange de cybermenaces entre la Russie et les États-Unis – ainsi qu’un reportage contesté de NBC News présentant des options qui auraient été soumises au président américain Joe Biden pour mener de « vastes cyberattaques » destinées à perturber l’invasion russe – les premiers signalements de cyberattaques se sont parfois révélés destructeurs et dommageables, sans toutefois se rapprocher des pires scénarios redoutés, comme des attaques contre les systèmes des services publics.
Un webinaire de SANS a détaillé aujourd’hui certaines des cyberattaques observées jusqu’à présent dans le conflit. Kevin Holvoet, du Centre for Cybersecurity Belgium (CCB), a déclaré que les attaques soutenues par la Russie menées ces derniers mois contre l’Ukraine et d’autres cibles comprenaient notamment :
- Attaques DDoS contre les administrations, l’armée, les établissements financiers et les moyens de communication
- Logiciels malveillants wipers, notamment le dernier en date, HermeticWiper identifié par ESET et Symantec
- Espionnage, notamment le ciblage d’entreprises américaines du secteur de la défense, ainsi que la nouvelle menace « SockDetour » signalée hier par Palo Alto Networks
- Défiguration de sites web
- Une attaque de la chaîne logistique logicielle (Kitsoft)
- Opérations d’influence et de désinformation
Les agences américaines et britanniques chargées de la cybersécurité ont également signalé cette semaine une nouvelle menace visant les équipements réseau, baptisée Cyclops Blink et attribuée au groupe Sandworm, lié à la Russie.
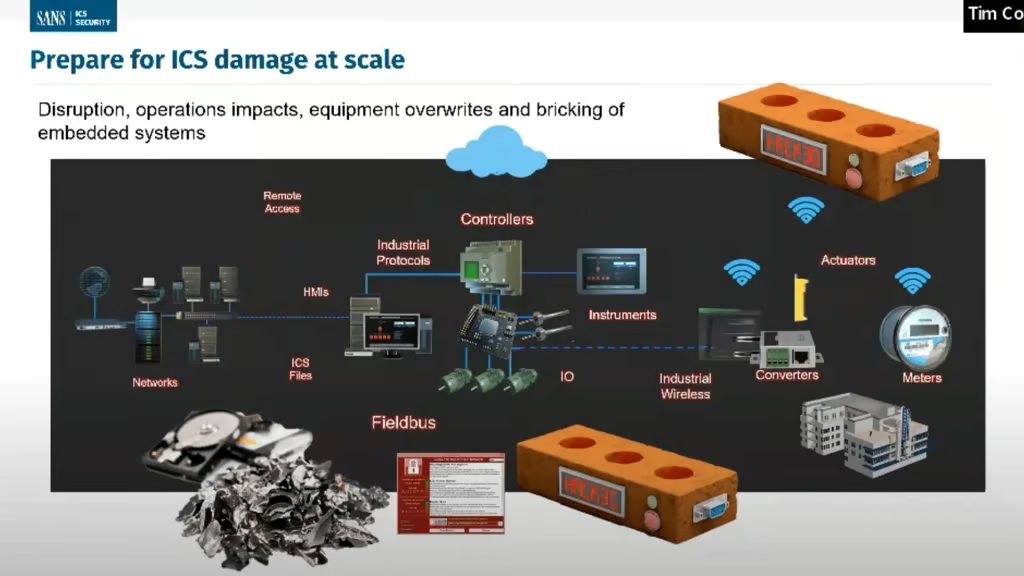
Même si les pires craintes ne se sont pas concrétisées jusqu’à présent, Tim Conway, directeur technique des programmes ICS et SCADA chez SANS, a déclaré que le pire scénario d’une cyberattaque contre une infrastructure critique serait des dommages paralysants à long terme.
« Le pire qui puisse arriver, ce n’est pas une panne, a déclaré Conway. Le pire qui puisse arriver, c’est que le système reste opérationnel afin de pouvoir être utilisé pour s’endommager lui-même ou endommager la charge, ce qui créerait des problèmes à beaucoup plus long terme et nécessiterait beaucoup plus de temps pour s’en remettre. »
Mesures de protection à prendre
Jake Williams, formateur principal chez SANS, a invité les spectateurs à relativiser la probabilité d’être victimes d’une cyberattaque menée par un État.
« Dans la plupart des entreprises, il est actuellement bien plus probable de subir une panne à la suite d’une erreur interne commise en réaction au FUD (peur, incertitude et doute) que d’une cyberattaque du gouvernement russe », a déclaré Williams.
Williams a invité les spectateurs à se concentrer sur les fondamentaux, comme l’hameçonnage, mots de passe et l’application de correctifs/mise à jour, car ils constituent toujours le point d’entrée de nombreuses attaques. Il a également recommandé plusieurs mesures de protection supplémentaires :
- Stratégies de journalisation tactiques et efficaces
- Contrôle du trafic sortant, notamment par le géoblocage
- Prévoir une mise en quarantaine rapide
- Mettre en place un contrôle des applications
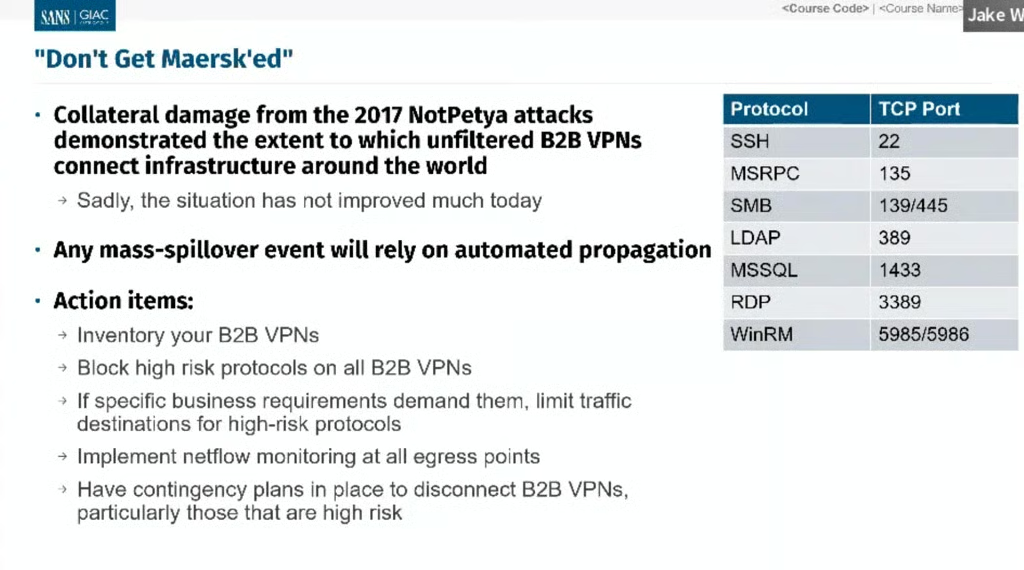
- Répertorier les VPN B2B et bloquer tous les protocoles à haut risque (voir la diapositive ci-dessous)
- Mettre en place une surveillance NetFlow sur tous les points de sortie
- Prévoir des plans d’urgence pour déconnecter tous les VPN B2B, en particulier ceux à haut risque
- Envisager d’empêcher le téléchargement de pilotes inconnus
Williams a déclaré que les spectateurs devraient consulter la page web de SANS consacrée à la crise en Ukraine pour se tenir au courant.
À lire également : Principaux outils de gestion des vulnérabilités
Mesures de sécurité à prendre « dès maintenant »
Mick Douglas, formateur principal chez SANS, a publié des conseils sur Twitter concernant les mesures de sécurité à prendre « dès maintenant », qui ont suscité beaucoup d’intérêt et feront bientôt l’objet d’un article sur le blog de SANS.
Douglas a déclaré que le « renforcement du contrôle des sorties » – c’est-à-dire des données quittant le réseau – était la seule chose sur laquelle il se concentrerait « dès maintenant ».
« Surveillez vos flux sortants. Les pare-feu fonctionnent dans les deux sens. Surveillez attentivement le trafic sortant. Les serveurs DMZ RÉPONDENT aux requêtes externes. Repérez les systèmes DMZ qui initient des connexions sortantes. C’est à cela que ressemble le fait de « téléphoner à la maison » [commande et contrôle, ou C2]. »
Il a déclaré que le géoblocage n’était pas une mesure de contrôle aussi importante. « Ne vous focalisez pas trop sur les blocages d’adresses IP. Le géoblocage présente certains avantages, mais les groupes russes n’utilisent des espaces d’adresses IP russes que lorsqu’ils veulent narguer leurs victimes. Commencez à considérer l’ensemble d’Internet comme hostile… parce qu’il l’est. »
Voir les meilleurs outils de surveillance réseau
Listes blanches et contrôles « Living off the Land »
Il a invité les utilisateurs à mettre en place l’établissement de listes blanches, ou listes d’autorisation, pour les applications. « Le contrôle des applications (autrefois appelé liste blanche) n’est plus un simple “plus appréciable”, a-t-il déclaré, mais le strict minimum. Quiconque prétend le contraire donne des conseils dépassés et dangereux. »
Il a déclaré qu’une liste de contrôle des applications ne devait pas être complexe. « Utilisez les fonctions de journalisation natives pour connaître les applications qui s’exécutent sur les systèmes », a-t-il écrit.
Si vous ne disposez pas d’un système EDR, il a recommandé Windows SRUM, qui conserve une vue glissante sur 30 jours de chaque fichier .exe exécuté. Il a partagé des liens vers des outils SRUM/ESE pour un seul hôte et plusieurs hôtes.
Pour surveiller l’utilisation normale des applications sur les hôtes Linux, il a recommandé d’utiliser auditd ou sysmon pour Linux « si vous ne disposez pas d’un EDR sophistiqué ou d’un outil capable de suivre ces informations ».
« Vous *devez* savoir comment vos systèmes sont utilisés pour deux raisons », a déclaré Douglas.
La première consiste à bloquer toute application qui ne figure pas dans votre liste approuvée. « [D]éfinissez les alertes de blocage sur la priorité maximale. Il peut s’agir d’un besoin légitime, et vous voudrez le corriger immédiatement. »
La seconde raison concerne les attaques « Living off the Land » (LOL), qui utilisent des fonctionnalités natives telles que PowerShell pour contourner les contrôles de sécurité. « C’est ce qu’utilisent les attaquants soutenus par des États lorsqu’ils y sont contraints, a-t-il déclaré. Ils permettent aux attaquants de contourner votre antivirus, et probablement aussi votre EDR. »
« Comme de nombreuses entreprises dépendent désormais excessivement de leur EDR et de leur SIEM, les attaques LOL sont très efficaces. Les attaquants se fondent dans le paysage. Ils utilisent des composants essentiels du système d’exploitation contre vous. Aucun de vos outils ne les arrêtera. Vous avez probablement déjà créé des exclusions pour les ports et protocoles utilisés par ces outils. »
« NE CROYEZ PAS non plus que vos outils heuristiques ou basés sur l’IA/ML vous sauveront, a-t-il déclaré, en recommandant une conférence du fondateur de TrustedSec, David Kennedy.
Remarque : l’année dernière, Symantec a ajouté une fonctionnalité de protection contre le « Living off the Land » à son offre EDR afin de désactiver les outils système inutilisés.
Contourner « absolument tous les contrôles »
Douglas a déclaré que sa petite entreprise, créée il y a cinq ans, avait contourné « absolument tous les contrôles » dans un laboratoire à 17 000 dollars US équipé d’un cluster Proxmox à trois nœuds et d’un système NAS de 14 To.
« Je peux émuler la plupart des entreprises, ou une part importante d’entre elles, a-t-il déclaré. Si mon cabinet spécialisé en sécurité informatique dispose de ces ressources… de quoi dispose une organisation soutenue par un État ? »
Les plans de réponse aux incidents devraient prévoir des procédures d’isolement rapides au niveau des hôtes et du réseau, fondées sur les contrôles qu’il recommande. « Entraînez-vous, a-t-il déclaré. Vous devrez travailler à une vitesse que vous n’avez probablement jamais atteinte auparavant. »
Les équipes de sécurité devraient accroître la journalisation tout en filtrant les éléments non essentiels et en réduisant la durée de conservation des données dont elles n’ont pas besoin à long terme. « De nombreux journaux vieillissent comme du lait », a-t-il déclaré, ajoutant : « Je pense notamment à vous, journaux DNS. »
« Une fois que les attaquants sont à l’intérieur, il vous suffit de les détecter une fois, a-t-il déclaré. Vous avez les meilleures informations sur les menaces informatiques] à portée de main. Exploitez les flux de CTI si vous en disposez. Vos hôtes vous indiquent comment ils sont utilisés et détournés. Commencez à les écouter. »
« La prévention est impossible. Essayez quand même. Passez à un modèle fondé sur la détection et la réponse. C’est notre chemin vers la victoire. »
« C’est un choix terrible, mais si je ne peux effectuer qu’une seule modification réseau maintenant, je renforce le contrôle des sorties »
Un abonné a demandé ce qu’il en était du « blocage des adresses bogon, du filtrage des routes, du blocage du trafic non sollicité directement sur les routeurs périphériques, des mesures de sécurité IPv6 et de la mise en place de pare-feu à états n’acceptant que les ports établis, associés et volontairement exposés. »
Douglas a déclaré que ce sont toutes des mesures que les professionnels de la sécurité devraient prendre, mais il a ajouté : « Cette liste est une sélection hiérarchisée des mesures qu’une entreprise devrait prendre *là, tout de suite* si elle ne l’a pas déjà fait. C’est un choix terrible, mais si je ne peux effectuer qu’une seule modification réseau maintenant… je renforce le contrôle des sorties. »
Pour aller plus loin : Meilleurs outils et logiciels de réponse aux incidents