

















Un utilisateur appelle le support pour signaler que son système est hors service. Après investigation, vous découvrez qu’il s’agit d’un ransomware. Les serveurs sont chiffrés et les fichiers portent l’extension « .locked ». Des demandes de rançon s’affichent sur les postes de travail.
Aucun problème, il suffit de restaurer, n’est-ce pas ? Vous disposez du site de reprise après sinistre (DR), de sauvegardes et de snapshots du réseau de stockage (SAN). Vous devriez avoir au moins trois moyens de récupérer vos données.
À mesure que vous essayez chacune de ces solutions, le nœud dans votre estomac se resserre et vous ressentez la pire sensation en informatique : comprendre que vous n’avez aucune sauvegarde pour assurer la récupération. Vous pensiez disposer de snapshots SAN, votre solution de récupération la plus rapide, mais les snapshots et la réplication SAN ont été désactivés. Vous cherchez votre réplica à froid sur votre site de reprise après sinistre, mais, comme vos serveurs de production, il a lui aussi été chiffré par le ransomware. Vos sauvegardes, le serveur de sauvegarde et tout le stockage des sauvegardes — tout a été chiffré par le ransomware.
Comment cela aurait-il pu être évité ?
Tandis que les équipes de sécurité superposent des mesures essentielles préventives et que des mesures de résilience doivent également être intégrées à l’architecture afin de réduire l’impact des attaques par ransomware sur vos sauvegardes, les sauvegardes immuables, la segmentation, la protection des identifiants et la protection de l’accès des administrateurs aux systèmes sont essentielles à la récupération.
Enfin, il est vital de protéger votre environnement de récupération. Il y a de fortes chances que l’attaquant soit toujours présent dans votre environnement et puisse faire échouer vos tentatives de récupération.
Voici donc ce qu’il vous faut pour être véritablement prêt à récupérer après une attaque par ransomware — les conseils d’un homme qui a dû relever ces défis.
1. Sauvegardes isolées et immuables
À mesure que les attaquants gagnent en sophistication, les sauvegardes immuables deviennent cruciales. Les sauvegardes immuables ne peuvent être ni modifiées ni écrasées. Il s’agit d’un concept nouveau. Historiquement, la plupart des sauvegardes écrasaient les plus anciennes au fil des rotations. Les sauvegardes immuables permettent d’ajouter des données, mais chaque bit écrit sur la sauvegarde est figé, à l’image de la protection en écriture d’une ancienne cassette audio. Vous vous en souvenez ?
L’isolation réseau signifie que la sauvegarde n’est pas active sur votre réseau. Un périphérique de stockage en réseau (NAS) ou un snapshot SAN présent sur votre réseau n’est pas isolé. L’isolation réseau empêche l’attaquant de supprimer ou de corrompre vos sauvegardes.
Lors de chaque incident lié à un ransomware au cours des trois dernières années, l’attaquant a corrompu les sauvegardes présentes sur le réseau. Il est important de noter que les sites de reprise après sinistre (DR) ne sont généralement pas isolés en raison du VPN actif entre la production et le site DR. Au fil des ans, j’ai vu de nombreux incidents liés à des ransomwares lors desquels le site DR était lui aussi chiffré. Souvent, le site DR constitue le point d’entrée de l’attaquant.
Les entreprises ont investi des millions de dollars dans les sites DR. Ces sites sont efficaces en cas de catastrophe naturelle, mais pas contre les attaques par ransomware, à moins que d’autres mesures, comme la segmentation, ne soient en place pour protéger l’environnement de reprise après sinistre.
la plupart des solutions de sauvegarde ne sont pas immuables par défaut
Il existe désormais de nombreuses solutions qui se prétendent immuables. Certaines le sont, mais la plupart des solutions ne sont pas immuables par défaut. Pour garantir l’immuabilité, vous devez prendre des mesures supplémentaires afin de configurer et d’architecturer votre stockage. Les solutions de sauvegarde AirGapd d’Airiam et Data Protection de Rubrik sont réputées pour leur immuabilité. la plupart des autres solutions se disent immuables mais dépendent du stockage cible, comme un compartiment Amazon S3, pour assurer leur immuabilité.
2. Segmentation
Lorsqu’un attaquant accède à votre réseau, il commence par effectuer une reconnaissance afin de découvrir ses prochaines cibles. Les acteurs malveillants ne peuvent pas pirater ce qu’ils ne voient pas.
Pour y parvenir, votre équipe informatique doit mettre en place une segmentation entre les serveurs, le stockage et les environnements de sauvegarde au moyen de réseaux locaux virtuels (VLAN), et inspecter le trafic inter-VLAN en le considérant comme non fiable. Tout le trafic inter-VLAN doit passer par un pare-feu. Ces mesures réduisent votre surface d’attaque en limitant ce qui est visible pour l’acteur malveillant.
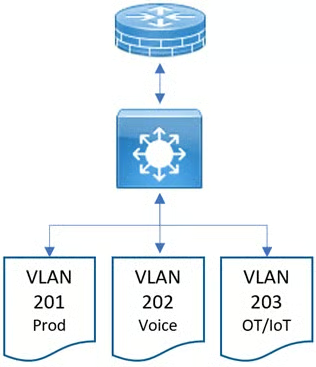
Ce processus va à l’encontre des pratiques habituelles de la plupart des administrateurs réseau, qui utilisent des pare-feu à la périphérie du réseau (Figure 1) et un commutateur rapide sur le LAN pour acheminer le trafic inter-VLAN. Cette configuration permet aux commutateurs, capables de déplacer le trafic beaucoup plus rapidement, de s’en charger. L’inconvénient est que le trafic n’est généralement pas analysé par un pare-feu, sauf s’il passe par celui-ci ; un attaquant présent sur le réseau peut donc se déplacer librement.
La situation idéale, illustrée dans une version simplifiée à la Figure 2, consiste à faire passer par un pare-feu tout le trafic circulant entre les VLAN. Cela ajoute-t-il de la latence ? Tant que le pare-feu est correctement dimensionné pour le trafic de votre réseau et configuré pour les types de trafic concernés, l’effet devrait être négligeable. Le problème est le suivant : les pare-feu suffisamment puissants pour gérer ce volume et cette vitesse de trafic sont coûteux. La situation idéale consiste à faire passer le trafic du LAN par des pare-feu coûteux. Dans les grandes entreprises, il peut s’agir d’une architecture en fabric de pare-feu plutôt que d’un seul pare-feu. Les pare-feu ont individuellement un débit limité.
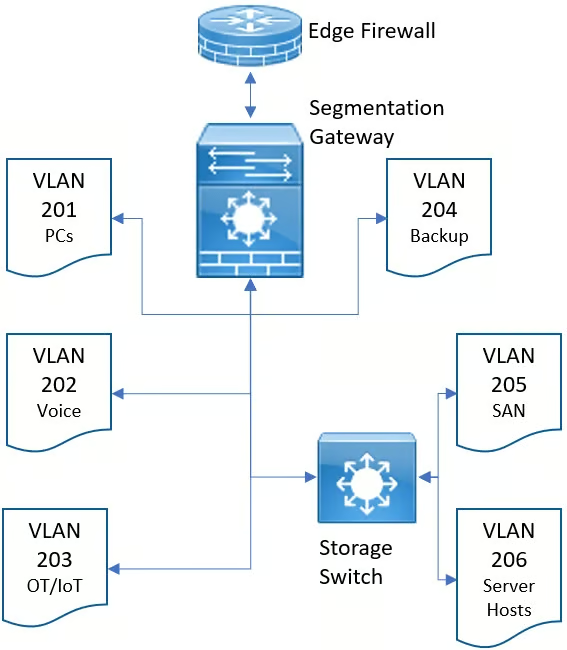
Les administrateurs réseau doivent mettre en œuvre l’idée zero trust d’une passerelle de segmentation, qui effectue une inspection par pare-feu et ajoute une segmentation et un contrôle fondés sur des règles de couche 7, selon les accès des utilisateurs, des appareils et des applications. Pour des raisons de stabilité et afin d’épargner au pare-feu l’ensemble du trafic de stockage SAN, l’administrateur réseau peut tout de même choisir de conserver le trafic de stockage sur un commutateur de stockage rapide. Notez que la Figure 2 est très simplifiée. La plupart des administrateurs réseau suivront le modèle Purdue pour la sécurité des systèmes de contrôle industriel (ICS) au sein du LAN OT/IoT. Penser en termes de passerelle de segmentation fait progresser votre organisation vers une architecture zero trust.
NDR et IDS ou pare-feu et passerelles de segmentation
Pour les entreprises qui ne peuvent pas se permettre une fabric de pare-feu et de passerelles de segmentation rapides et coûteux, une solution intermédiaire consiste à mettre en place des solutions de détection et réponse réseau (NDR) et des systèmes de détection d’intrusion (IDS).
En envoyant un TAP réseau (test access point) ou un port SPAN (port miroir) vers un dispositif IDS ou NDR, il est possible d’identifier le trafic suspect et de déclencher une réponse sur le réseau. Cette réponse peut consister à désactiver un port, interrompre une session, isoler un hôte ou bloquer un utilisateur. De nos jours, cette automatisation est généralement assurée par un système de détection et réponse étendues (XDR) ou d’orchestration, d’automatisation et de réponse de sécurité (SOAR).
En plus de créer la segmentation en VLAN et d’ajouter des politiques de sécurité pour la passerelle de segmentation, il est essentiel de verrouiller les listes de contrôle d’accès (ACL) entre les réseaux. Aucun VLAN ne doit disposer d’un accès sans restriction à un autre VLAN. Dans le cas de la Figure 2, j’empêcherais tout accès au VLAN de sauvegarde 204 depuis les autres VLAN, à l’exception du VLAN des hôtes de serveurs 206. Dans le cas de Veeam, je n’autoriserais le trafic qu’entre les proxys de sauvegarde Veeam, le serveur de sauvegarde Veeam, VMware vCenter et le stockage des sauvegardes. Tout autre trafic doit être bloqué vers le réseau de sauvegarde.
Même si vous disposez d’une ancienne architecture réseau sans aucune technologie de nouvelle génération, vous devriez pouvoir mettre en place une segmentation de base avec des VLAN et des listes de contrôle d’accès (ACL).
En savoir plus sur les pare-feu, microsegmentation, NDR et IDS produits
3. Protection de l’authentification
Si les serveurs de sauvegarde sont joints au domaine, que vCenter est configuré pour utiliser l’authentification unique (SSO) sur le domaine et que le stockage SAN est configuré pour l’authentification LDAP sur le domaine, les sauvegardes, les hôtes et le SAN sont compromis à chaque fois. Bien que l’authentification centralisée de toutes les ressources informatiques simplifie considérablement la gestion informatique, elle facilite également la tâche de l’attaquant. La compromission du domaine permet à l’attaquant de détruire toutes les autres ressources informatiques, notamment les serveurs, le stockage et les sauvegardes.
Conservez toute l’infrastructure en dehors d’Active Directory ou de tout autre système d’authentification centralisé. Protégez les identifiants de ces systèmes dans un gestionnaire de mots de passe ou un coffre-fort d’identifiants, tel qu’Azure Key Vault ou AWS Secrets Manager. Cela est tout aussi important pour les clés de stockage et les certificats. Les identifiants Amazon AWS S3 et les clés d’accès Azure Blob doivent être protégés dans un coffre-fort d’identifiants afin que l’attaquant ne puisse pas les capturer facilement et vous gâcher la journée.
Si vous utilisez le chiffrement dans votre solution de sauvegarde ou votre environnement de stockage, conserver une copie de votre clé de chiffrement dans votre coffre-fort de clés vous sauvera la mise lorsque l’accès à tous vos autres systèmes sera interrompu. Utilisez des coffres-forts pour tous vos secrets. J’ai vu des personnes incapables de restaurer leurs sauvegardes parce qu’elles n’avaient pas stocké leur clé de chiffrement des sauvegardes dans un emplacement cloud sécurisé. De même, conservez les identifiants de vos solutions de sauvegarde cloud dans votre coffre-fort de clés, et non dans un fichier de mots de passe sur votre partage informatique. Si l’attaquant capture le mot de passe de votre solution de sauvegarde cloud, il peut perturber ou détruire vos sauvegardes, voire annuler votre compte. Considérez vos noms d’utilisateur et vos mots de passe comme aussi précieux que n’importe quel autre joyau de la couronne de votre réseau.
4. Postes de travail administratifs
Vos administrateurs, qu’il s’agisse de l’administrateur cloud, de l’administrateur de bases de données (DBA) ou d’un informaticien généraliste, conservent généralement des secrets sur leurs postes de travail. J’ai souvent constaté ce phénomène dans des profils SSH contenant des clés permettant d’accéder à des VM dans Amazon AWS. Un développeur ou un administrateur cloud peut disposer de clés SSH sur son poste de travail, lesquelles servent d’identifiants.
En outre, l’accès aux environnements est souvent limité aux ordinateurs portables ou de bureau des administrateurs. Tout peut être protégé par des pare-feu, mais l’accès à l’environnement VMware peut être limité à l’adresse IP du poste de travail de l’administrateur. Les attaquants qui effectuent une reconnaissance interne peuvent identifier les administrateurs présents sur un réseau et le confirmer grâce à leurs profils LinkedIn. Ils savent que s’ils piratent le poste de Bob, ils auront accès aux environnements de serveurs et de sauvegarde — et c’est ce qu’ils font. C’est ainsi que les acteurs malveillants accèdent souvent à votre SAN et même à votre console de détection et réponse sur les terminaux (EDR) ou à votre console antivirus. Vos administrateurs disposent de sessions actives et ouvertes. Tout ce que l’attaquant a à faire est d’ouvrir le navigateur et d’effectuer les changements de son choix.
La morale de l’histoire est que les ressources des administrateurs doivent être protégées aussi rigoureusement que celles de vos principaux dirigeants. Au minimum, une journalisation continue, l’EDR et l’authentification multifacteur (MFA) doivent être en place pour accéder à ces machines administratives. Idéalement, des solutions d’accès réseau zero trust (ZTNA) ou des solutions de sécurité en périphérie (SSE) obligent l’administrateur à se réauthentifier chaque fois qu’il tente d’accéder à des ressources administratives hautement protégées. Ces ressources constituent le maillon faible recherché par l’acteur malveillant, et l’accès à cet ordinateur administratif est souvent son filon le plus lucratif.
5. Ce n’est pas terminé quand c’est terminé
L’incident suivant survient et vous êtes parfaitement préparé à récupérer vos données. Vos sauvegardes ont été protégées et vous pouvez restaurer. Vous rebondissez rapidement, remettez votre organisation en ligne en quatre heures, vous félicitez et vous vous couronnez héros du jour.
Mais le soir venu, vos machines sont de nouveau attaquées. Que s’est-il passé ?
Vous avez omis de faire deux choses. Premièrement, vous devez protéger votre environnement de récupération. Deuxièmement, vous devez comprendre comment l’attaque initiale s’est produite afin d’en tirer les leçons et de combler les failles et les points d’entrée. Même si vous avez récupéré vos systèmes, l’attaquant a probablement toujours accès à votre réseau.
Voici une liste de contrôle pour prendre les mesures de confinement nécessaires et expulser efficacement l’attaquant.
- Mettez en place l’EDR et une surveillance active afin d’identifier les communications de commande et contrôle (C2). L’EDR doit également contribuer à détecter les portes dérobées et les chevaux de Troie d’accès à distance (RAT) laissés par l’acteur malveillant.
- Vérifiez que vos pare-feu périphériques sont de nouvelle génération et disposent d’abonnements de prévention des intrusions recherchant activement les attaques réseau entrantes et les bloquant. Ce sont deux mesures que n’importe qui peut renforcer sans comprendre la nature de l’attaque.
- Comprenez le vecteur d’attaque afin de déterminer les prochaines étapes cruciales. Devez-vous renforcer la sécurité de la messagerie ? Désactiver le VPN ? Fermer les services de bureau à distance (RDP) ouverts ? Désactiver le site web jusqu’à la correction d’une vulnérabilité critique ? Donnez-vous l’assurance que la porte de l’attaquant n’est pas grande ouverte.
- Si vous avez subi une compromission, partez du principe que vos identifiants ont été compromis. Par mesure standard, notre équipe réinitialise les mots de passe de tous les comptes utilisateur, administrateur et système, et renouvelle deux fois le « golden ticket » d’Active Directory.
- Forcez l’utilisation de la MFA sur tous les comptes interactifs. Si un utilisateur ou un administrateur se connecte à quoi que ce soit, une invite MFA doit lui demander une vérification. Renforcer Active Directory à l’aide des contrôles du Center for Information Security (CIS) constitue une bonne dernière étape. Renforcez les politiques de mots de passe, la signature SMB, les exigences relatives aux certificats, etc.
- Récupérez vos systèmes dans un environnement de quarantaine. L’attaquant ou son automatisation peut réinfecter vos systèmes récupérés pendant que vous les restaurez à partir des sauvegardes. Restaurez-les dans un VLAN de quarantaine isolé. Vous pourrez basculer les VLAN vers la production une fois la restauration terminée. Restaurer dans un environnement déjà compromis met votre récupération en danger et peut entraîner un cycle vicieux d’attaques et de récupérations.
J’ai des dizaines d’histoires de guerre pour étayer chacun des concepts abordés ici et je pourrais probablement écrire un livre un jour. Pour l’instant, il est important pour moi d’aider les professionnels de la sécurité et de l’informatique du monde entier à renforcer leur résilience face à ces attaques. Vous subirez une attaque par ransomware dans un avenir proche si ce n’est pas déjà fait. L’essentiel sera votre capacité à rebondir.
Note de la rédaction : L’auteur était intervenant lors du MITRE ResilienCyCon du mois dernier (voir You Will Be Breached So Be Ready).