

















Microsoftの復旧システムは、封じ込めるはずだった障害の拡大を助けてしまった。
Microsoftが11月15日付で公開した暫定報告書は、数カ月前から存在していたソフトウェアの欠陥が、11月12~13日に発生したMicrosoft 365の障害にどう影響したかを説明している。この障害により、Exchange Onlineのメールボックスへのアクセスが遮断され、メールの配信が24時間近く遅延したほか、DefenderやPurviewなど、Exchangeに依存するサービスの機能にも影響が及んだ。
セキュリティチームにとって、この障害は実務上の懸念を浮き彫りにした。すなわち、それを支えるサービスが停止したときにも、インシデント通知や対応手順を利用可能な状態に保てるかという問題だ。
増加したトラフィックが休眠状態のソフトウェア欠陥を露呈
According to Microsoftのインシデント後の暫定報告書によると、問題はMicrosoft 365への接続を処理するサーバー向けに7月に提供されたWindowsのソフトウェア修正に端を発した。特定の条件下では、ソフトウェア内で競合する処理が過剰な処理能力とメモリを消費し、やがてサーバーが応答を停止した。
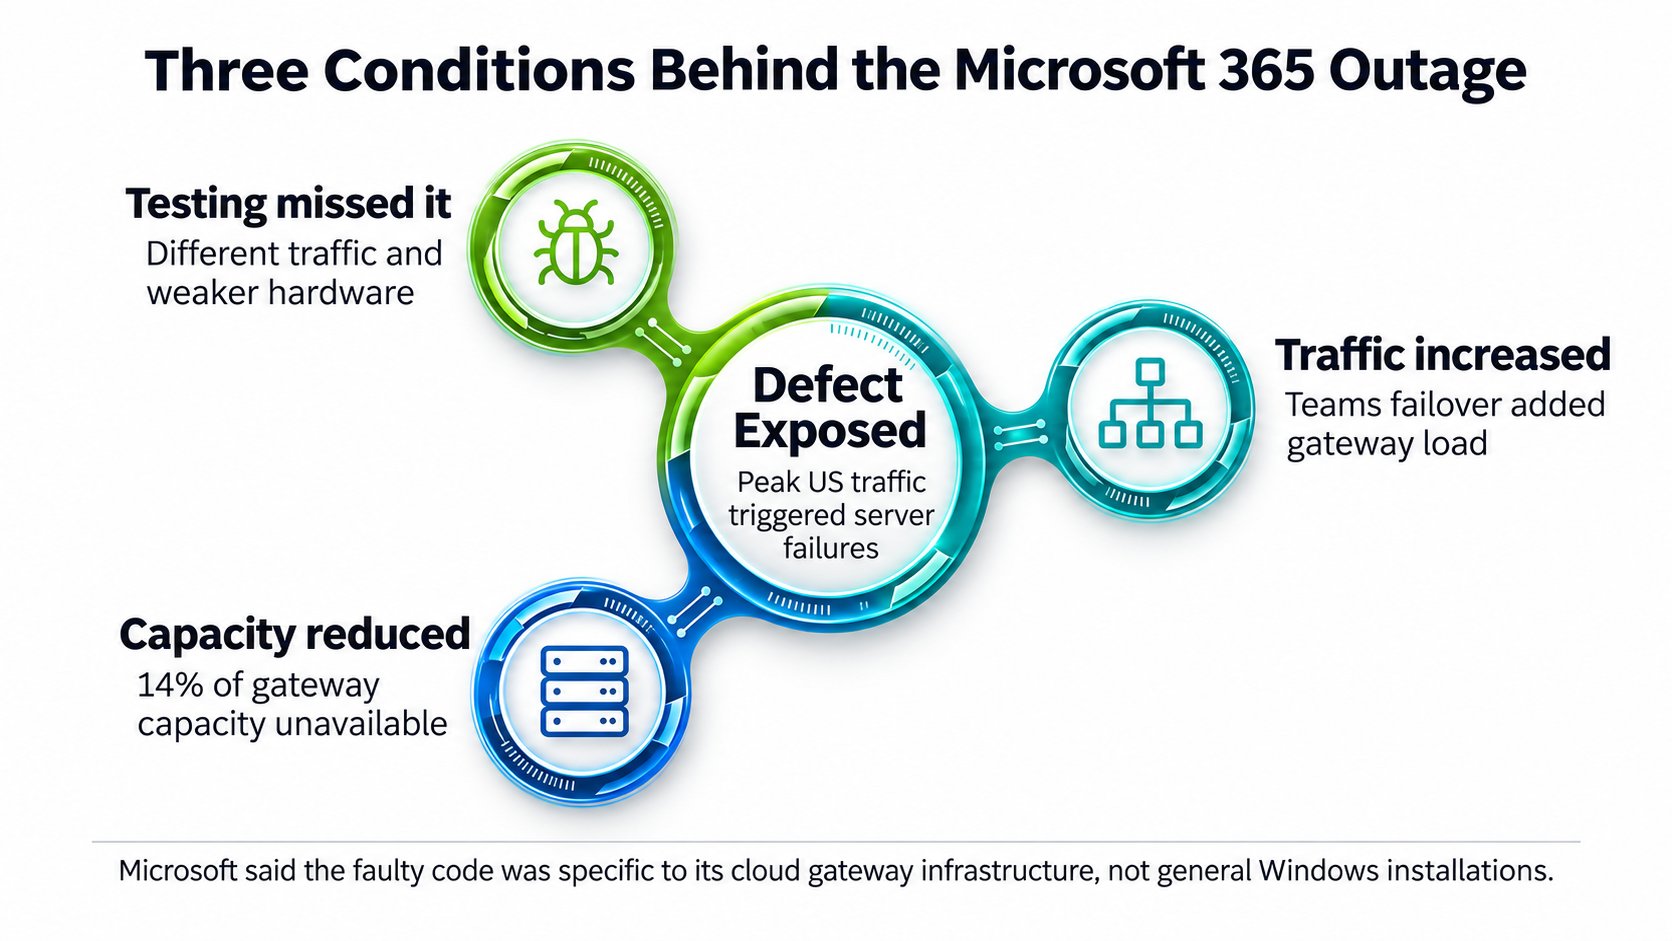
こうした条件が、次の問題を表面化させた:
- テストで見逃されたバグ。Microsoftのテストでは異なるトラフィックパターンと性能の低いマシンを使っていたため、新しいサーバーでプロセッサコア数が増えると悪化する問題を見逃した。この結果は、 パッチ管理プロセスに、実運用を代表する条件下でのテストを含めるべき理由を示している。
- トラフィックの急増。障害発生の約15時間前、Teamsの定常的なフェイルオーバーによって、追加のトラフィックがExchange Onlineと共有するゲートウェイに移された。
- 利用可能な容量の減少。ゲートウェイ容量の約14%は、無関係な問題によってすでに利用できなくなっており、増加した需要を処理できるサーバーが少なくなっていた。
これらが重なり、米国のトラフィックがピークを迎える時間帯に欠陥が露呈した。Microsoftは、問題のあるコードが自社のクラウドゲートウェイ基盤に固有のものであり、通常のWindowsインストールには影響しなかったことを確認した。
自動復旧が障害をリージョン間に拡大
サーバーが応答を停止した際にもサービスを利用可能に保つため、トラフィック管理システムが用意されていた。ところが実際には、接続を正常なマシンへ振り向けた結果、負荷が増大し、それらのサーバーでも同じ欠陥が発生した。2時間以内に、欠陥はゲートウェイ全体に広がった。最悪の時点では、サーバーの80%超が応答しなくなった。
障害を個別のインフラストラクチャーパーティション内に封じ込めるための安全策も、拡大を食い止められなかった。暫定報告では、その理由を十分に説明していない。TeamsとSharePointは代替ゲートウェイへ移行でき、より早く復旧したが、Exchange Onlineは必要な規模で同じ切り替えを行えなかった。メールボックスへのアクセスとメール配信は深刻な影響を受け続けた。
障害が発生したサーバーを再起動しても、ほとんど改善は見られなかった。待機中のトラフィックがすぐにサーバーを再び過負荷にし、数カ月前に展開されたソフトウェア変更を標準のロールバック機構で簡単に元へ戻すこともできなかった。最終的にエンジニアは、以前の動作していたコードを復元する更新プログラムを開発し、サーバーグループを段階的にオンラインへ戻した。
Microsoftはその後、容量を増強し、追加の監視およびトラフィック管理の安全策を導入した。長期的な是正措置を詳述する最終報告書は、11月20日に公開される見込みだ。
インシデント対応がExchangeに依存していないか確認する
セキュリティチームにとっての懸念は、従業員が受信トレイにアクセスできなくなることだけにとどまらない。Microsoftは、影響を受けたサービスの中に、Exchangeに依存するDefenderとPurviewの機能が含まれていたと明らかにした。
組織独自の対応手順が、さらなる依存関係を生むこともある。Microsoft Defender XDRでは、管理者が インシデントのメール通知を設定でき、アラートの重大度に基づく通知にも対応している。それらのメッセージをExchange Onlineのメールボックスへ転送するセキュリティオペレーションセンターは、Exchangeの障害発生中に通知を受信したり、アクセスしたりすることが難しくなる可能性がある。
これは潜在的な障害シナリオであり、今回の障害によって組織が脅威を見逃したという確定的な事実ではない。検知、通知の配信、アナリストによるアクセスはそれぞれ別の段階であり、自組織の環境でどの段階が利用可能なままなのかを確認する必要がある。
組織がこの構成を利用している場合、Exchangeの障害によって対応が中断されるかどうかを確認するには、次の3点をチェックするとよい。
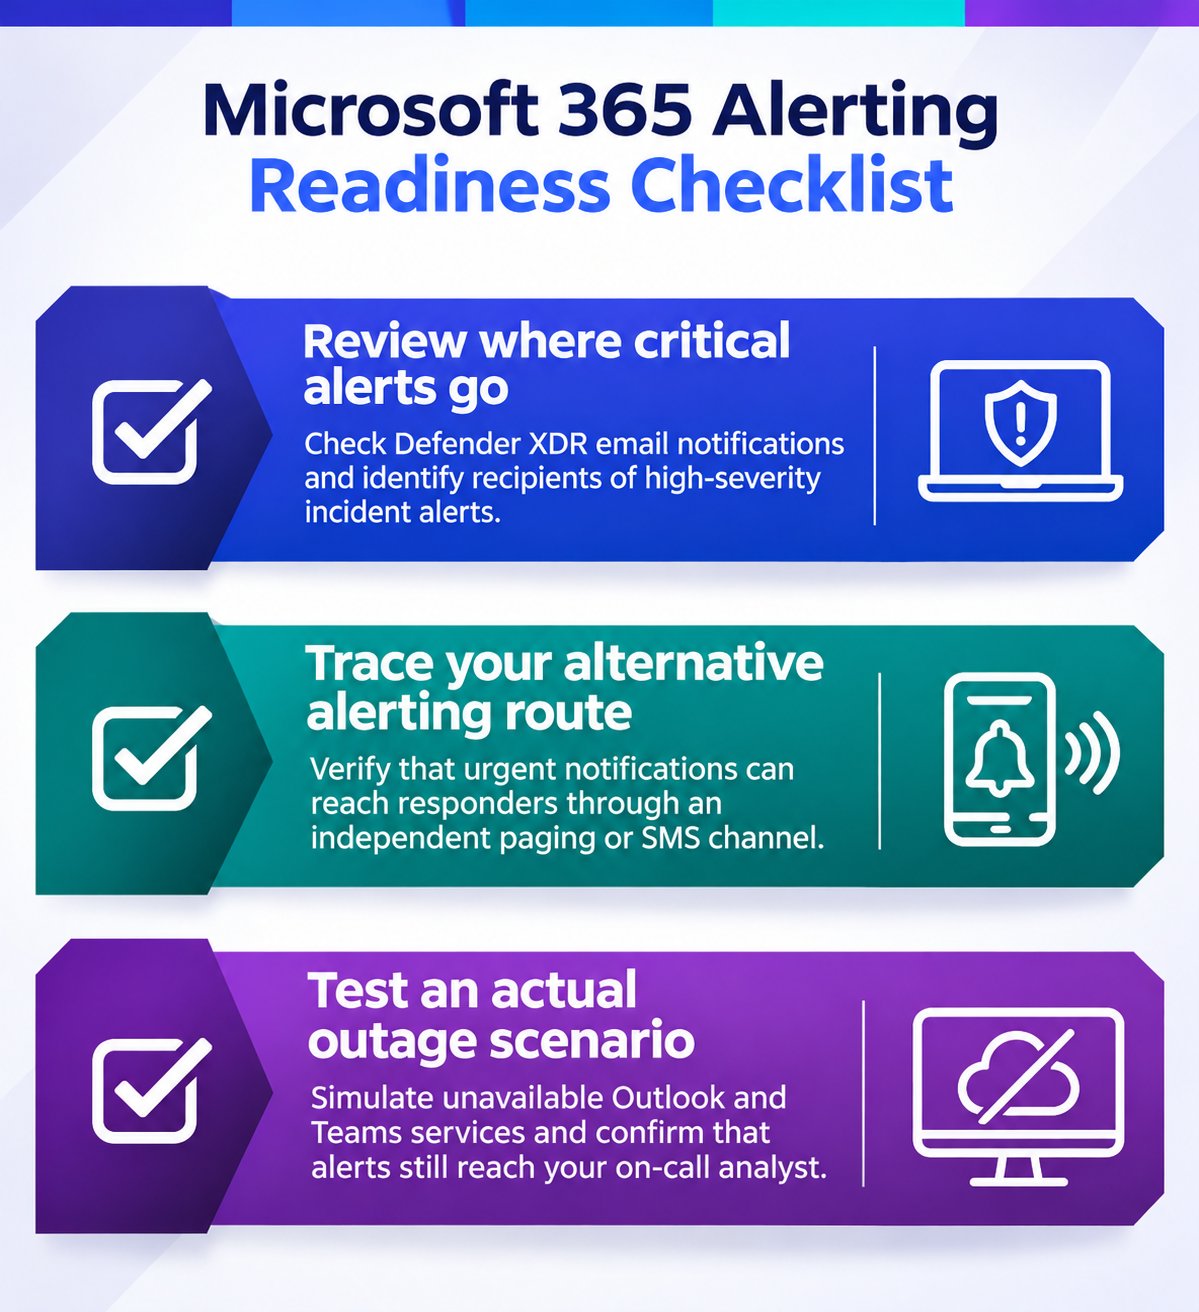
11月の障害の影響を受けた組織は、通信障害によって実際のインシデントへの対応が遅れなかったかどうかも確認すべきだ。Microsoft Defender XDRのインシデント発生時刻を、通知の配信および確認の記録と SIEMまたは利用可能であればインシデント管理プラットフォームから照合する。
インシデント後のレビューでは、通知の遅延、調査ツールへのアクセス不能、確認済みの監視上の空白を区別する。そのうえで、 インシデント対応計画に何が機能しなかったかを反映し、是正措置の担当を割り当て、変更後に対応プロセスを再テストする。
関連記事:脅威調査の遅延からコンプライアンス対応プロセスの中断まで、Microsoftの障害は複数の運用リスクを露呈させた。セキュリティチームが確認すべき点を見ていこう。