

















Les systèmes de récupération de Microsoft ont contribué à propager la panne qu’ils étaient censés contenir.
Le rapport préliminaire de Microsoft, daté du 15 novembre, explique comment un défaut logiciel vieux de plusieurs mois a contribué à la panne de Microsoft 365 des 12 et 13 novembre. La perturbation a bloqué l’accès aux boîtes aux lettres Exchange Online et retardé la distribution des e-mails pendant près de 24 heures, tout en affectant des fonctionnalités dépendantes d’Exchange dans des services comme Defender et Purview.
Pour les équipes de sécurité, cette défaillance soulève une question concrète : les notifications d’incident et les procédures de réponse peuvent-elles rester disponibles lorsque les services qui les prennent en charge cessent de fonctionner ?
Un trafic supplémentaire a révélé un défaut logiciel dormant
Selon le rapport préliminaire de Microsoft sur l’incident, le problème trouve son origine dans une mise à jour logicielle de Windows publiée en juillet pour les serveurs qui gèrent les connexions à Microsoft 365. Dans certaines conditions, des opérations concurrentes au sein du logiciel consommaient une quantité excessive de puissance de calcul et de mémoire, jusqu’à ce que les serveurs cessent de répondre.
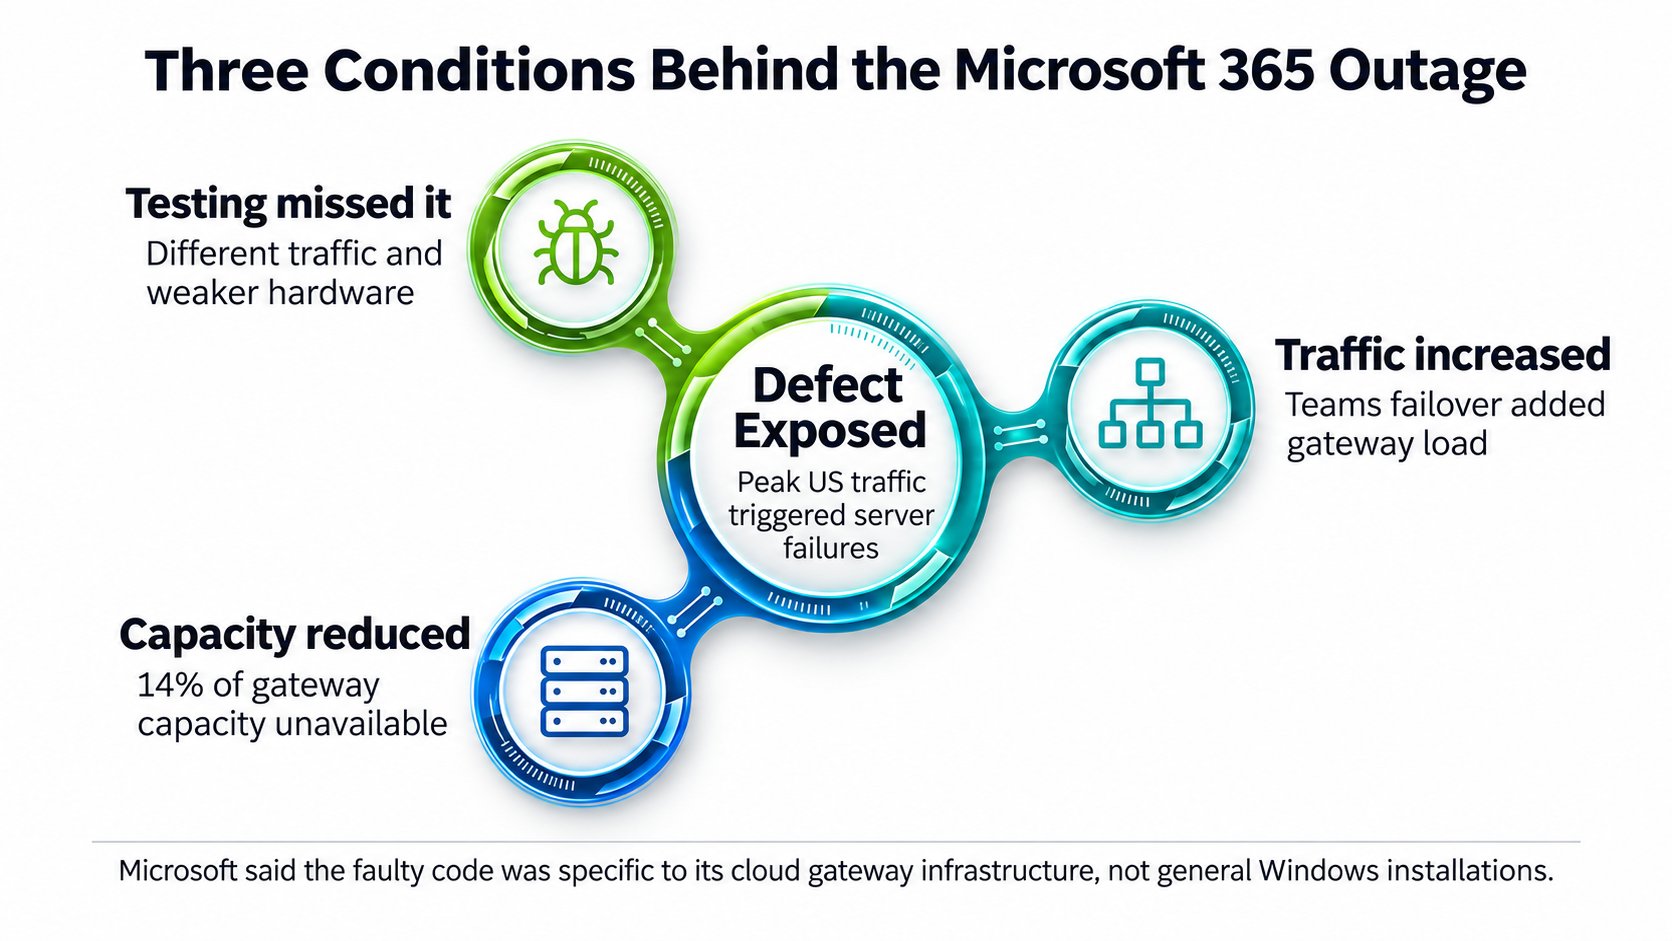
Ces conditions ont fait apparaître le défaut :
- Un bug passé inaperçu lors des tests. Les tests de Microsoft utilisaient des profils de trafic différents et des machines moins puissantes, ce qui n’a pas permis de détecter un problème qui s’aggravait sur les serveurs plus récents dotés de davantage de cœurs de processeur. Ces résultats montrent pourquoi le processus de gestion des correctifs doit inclure des tests réalisés dans des conditions de production représentatives.
- Une hausse soudaine du trafic. Environ 15 heures avant la panne, un basculement automatique de Teams effectué dans le cadre des opérations courantes a redirigé du trafic supplémentaire vers la passerelle partagée avec Exchange Online.
- Une capacité moindre disponible. Près de 14 % de la capacité de la passerelle était déjà indisponible en raison d’un problème sans rapport, laissant moins de serveurs pour gérer la demande accrue.
Ensemble, ces facteurs ont révélé le défaut pendant les heures de pointe du trafic aux États-Unis. Microsoft a confirmé que le code défectueux était propre à son infrastructure de passerelles cloud et n’affectait pas les installations Windows classiques.
La récupération automatique a propagé la panne entre les régions
Les systèmes de gestion du trafic étaient censés maintenir les services disponibles lorsque les serveurs cessaient de répondre. Au lieu de cela, ils ont redirigé les connexions vers des machines saines, augmentant leur charge de travail jusqu’à ce que ces serveurs rencontrent le même défaut. En l’espace de deux heures, le défaut s’était propagé à l’ensemble du parc de passerelles. Au plus fort de la panne, plus de 80 % de ses serveurs ne répondaient plus.
Les garde-fous destinés à contenir les défaillances dans des partitions d’infrastructure distinctes n’ont pas non plus réussi à stopper la propagation. Le compte rendu préliminaire n’explique pas entièrement pourquoi. Teams et SharePoint pouvaient basculer vers d’autres passerelles et ont récupéré plus rapidement, mais Exchange Online ne pouvait pas effectuer le même basculement à l’échelle requise. L’accès aux boîtes aux lettres et la distribution des e-mails sont restés gravement perturbés.
Le redémarrage des serveurs défaillants n’a apporté qu’un soulagement limité. Le trafic en attente les a rapidement submergés de nouveau, tandis que les mécanismes standard de restauration ne pouvaient pas facilement annuler une modification logicielle déployée plusieurs mois auparavant. Les ingénieurs ont finalement développé une mise à jour rétablissant le code qui fonctionnait auparavant, puis ont remis les groupes de serveurs en ligne progressivement.
Depuis, Microsoft a augmenté la capacité et mis en place des mesures supplémentaires de surveillance et de gestion du trafic. Un rapport final détaillant les mesures correctives à plus long terme est attendu le 20 novembre.
Vérifiez si la réponse aux incidents dépend d’Exchange
Pour les équipes de sécurité, le problème ne se limite pas à la perte d’accès des employés à leur boîte de réception. Microsoft a identifié parmi les services touchés des fonctionnalités de Defender et de Purview dépendantes d’Exchange.
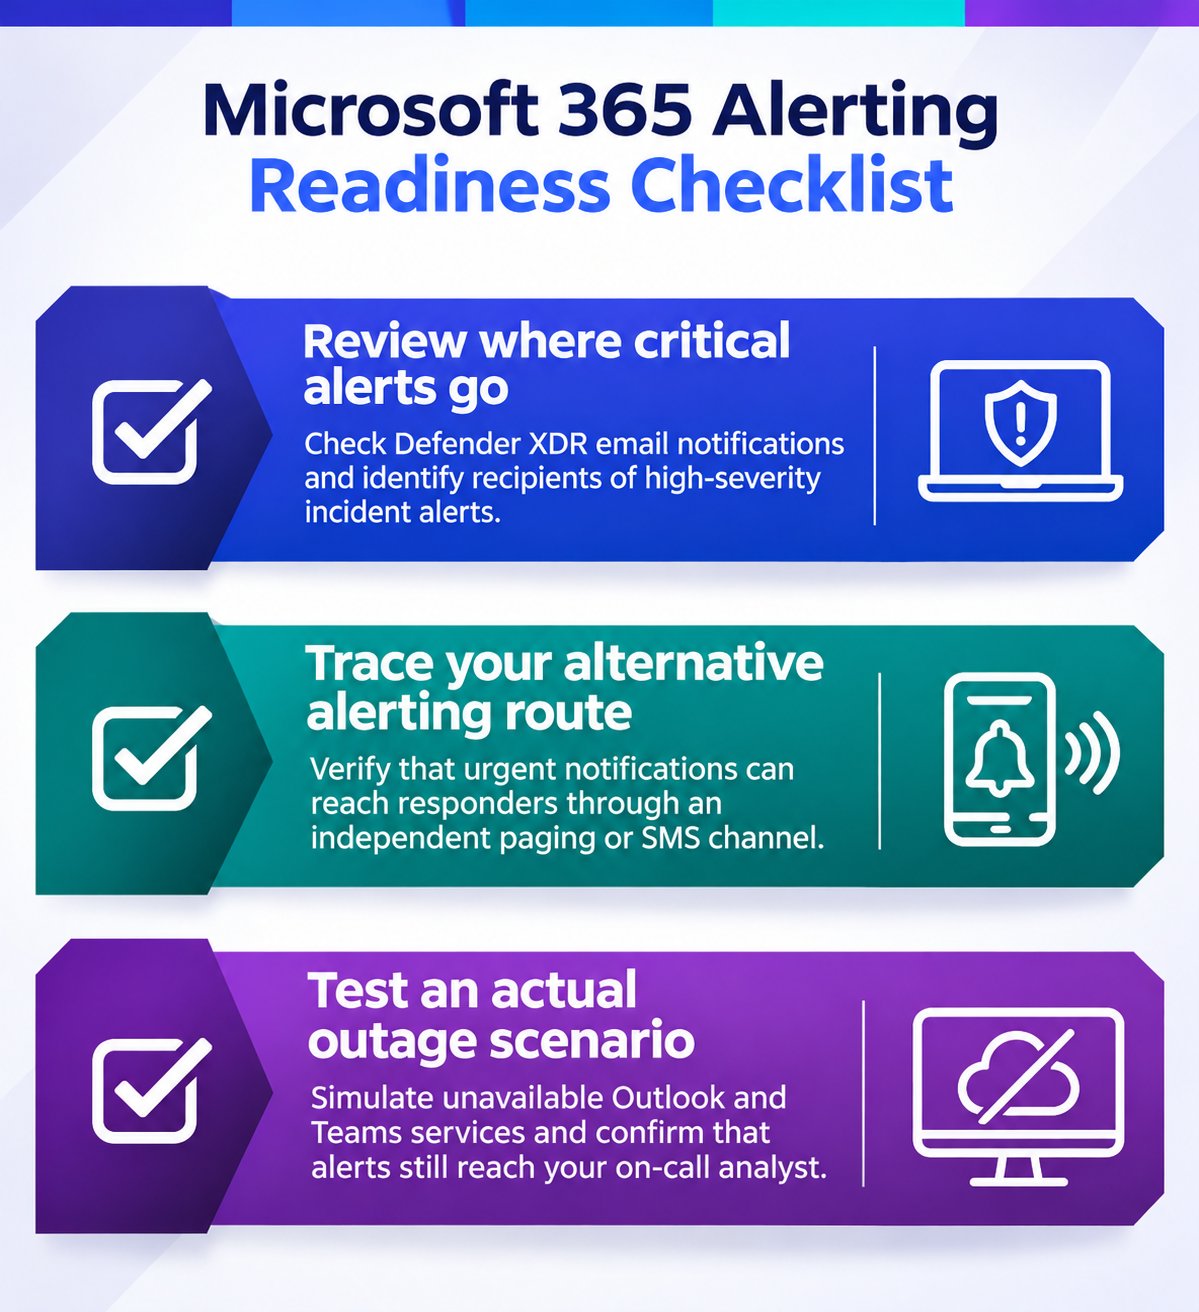
Les propres procédures de réponse d’une organisation peuvent introduire des dépendances supplémentaires. Microsoft Defender XDR permet aux administrateurs de configurer des notifications par e-mail pour les incidents, notamment des notifications fondées sur la gravité des alertes. Un centre des opérations de sécurité qui achemine ces messages vers une boîte aux lettres Exchange Online pourrait avoir des difficultés à les recevoir ou à y accéder pendant une panne d’Exchange.
Il s’agit d’un scénario de défaillance possible, et non d’un constat confirmé selon lequel cette panne aurait conduit des organisations à manquer des menaces. La détection, l’envoi des notifications et l’accès des analystes constituent des étapes distinctes ; les équipes doivent déterminer lesquelles restent disponibles dans leur environnement.
Si votre organisation utilise cette configuration, trois vérifications peuvent aider à déterminer si une panne d’Exchange interromprait votre réponse :
Les organisations touchées par la panne de novembre devraient également vérifier si des problèmes de communication ont retardé leur réponse à des incidents réels. Comparez les horodatages des incidents de Microsoft Defender XDR aux enregistrements de distribution des notifications et d’accusé de réception du SIEM ou de la plateforme de gestion des incidents, lorsque ces données sont disponibles.
Profitez de l’analyse post-incident pour distinguer les notifications retardées, les outils d’investigation inaccessibles et les éventuelles lacunes de surveillance avérées. Mettez à jour le plan de réponse aux incidents en indiquant ce qui a échoué, attribuez les mesures correctives et retestez le processus de réponse une fois les changements effectués.
À lire aussi : De l’analyse des menaces retardée aux processus de conformité interrompus, la panne de Microsoft a révélé plusieurs risques opérationnels. Découvrez ce que les équipes de sécurité devraient examiner.