

















Die Wiederherstellungssysteme von Microsoft trugen dazu bei, den Ausfall zu verbreiten, den sie eigentlich eindämmen sollten.
Der vorläufige Bericht von Microsoft vom 15. Nov. erläutert, wie ein Monate alter Softwarefehler zum Ausfall von Microsoft 365 am 12.–13. Nov. beitrug. Die Störung blockierte den Zugriff auf Exchange-Online-Postfächer und verzögerte die E-Mail-Zustellung fast 24 Stunden lang. Außerdem waren Exchange-abhängige Funktionen in Diensten wie Defender und Purview betroffen.
Für Sicherheitsteams wirft der Ausfall eine praktische Frage auf: Können Benachrichtigungen zu Sicherheitsvorfällen und Reaktionsverfahren verfügbar bleiben, wenn die sie unterstützenden Dienste ausfallen?
Zusätzlicher Datenverkehr legte einen ruhenden Softwarefehler offen
Laut dem vorläufigen Bericht von Microsoft zum Vorfallging das Problem auf ein Windows-Softwareupdate vom Juli für Server zurück, die Verbindungen zu Microsoft 365 verarbeiten. Unter bestimmten Bedingungen verbrauchten konkurrierende Vorgänge innerhalb der Software übermäßig viel Prozessorleistung und Arbeitsspeicher, bis die Server nicht mehr reagierten.
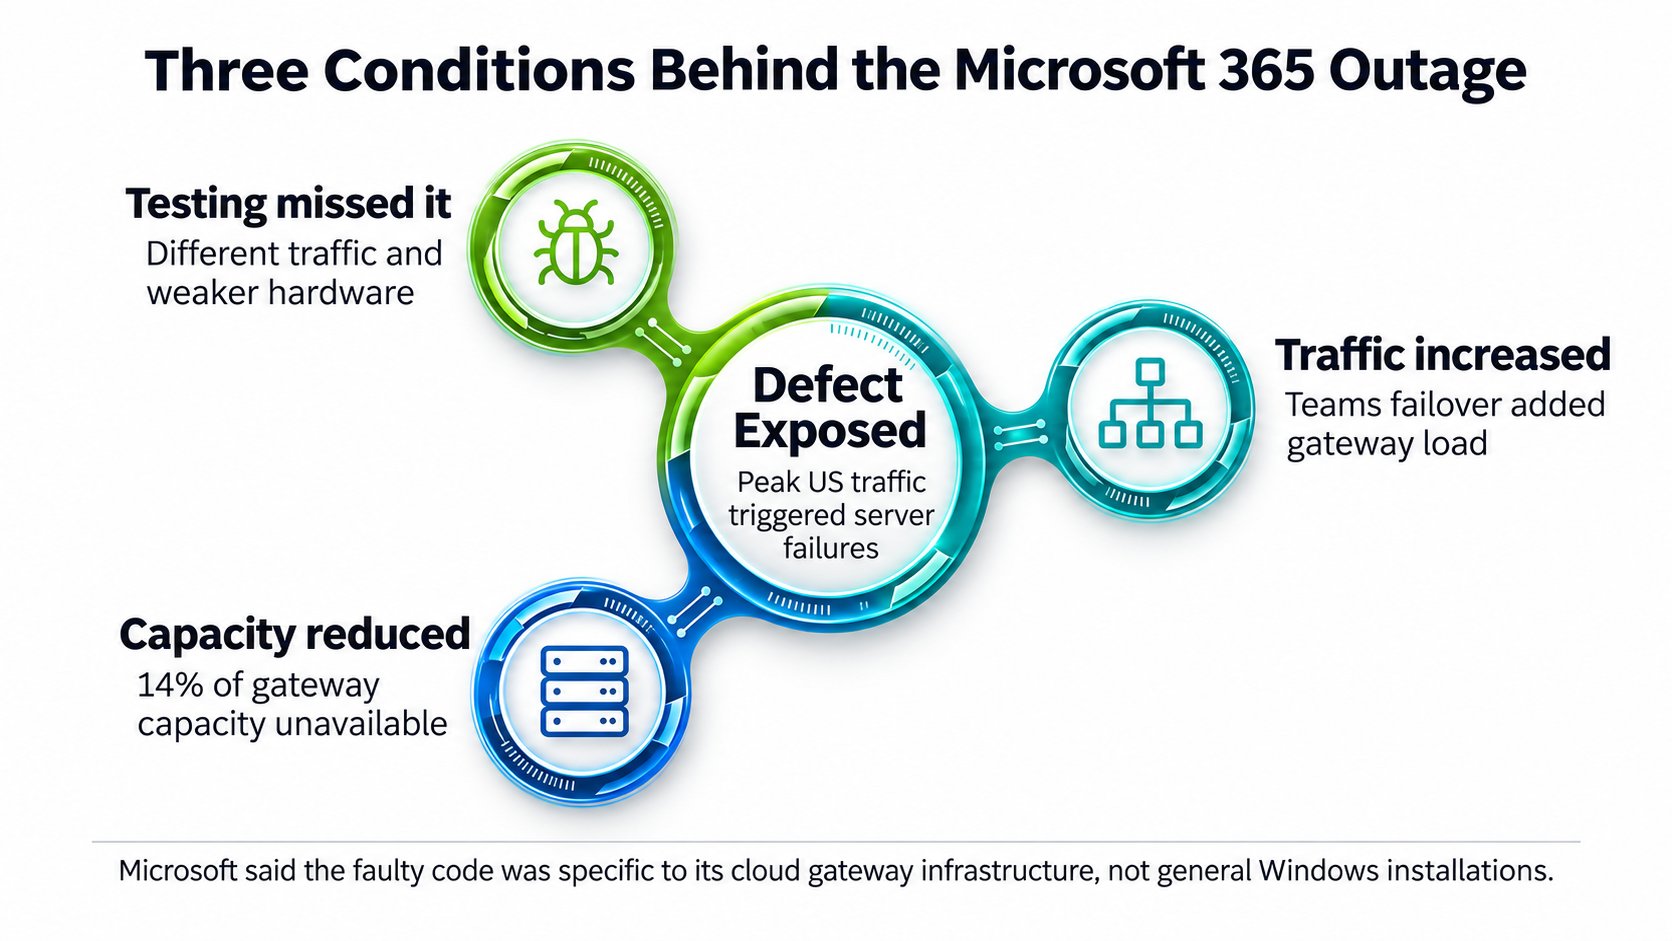
Diese Bedingungen brachten den Fehler ans Licht:
- Ein beim Testen übersehener Fehler. Die Tests von Microsoft verwendeten andere Datenverkehrsmuster und weniger leistungsfähige Rechner und erfassten daher ein Problem nicht, das sich auf neueren Servern mit mehr Prozessorkernen verschärfte. Die Ergebnisse zeigen, warum der Prozess für die Patchverwaltung Tests unter repräsentativen Produktionsbedingungen umfassen sollte.
- Ein plötzlicher Anstieg des Datenverkehrs. Etwa 15 Stunden vor dem Ausfall verlagerte ein routinemäßiger Teams-Failover zusätzlichen Datenverkehr auf das Gateway, das gemeinsam mit Exchange Online genutzt wurde.
- Weniger verfügbare Kapazität. Nahezu 14 % der Gateway-Kapazität waren aufgrund eines unabhängigen Problems bereits nicht verfügbar, sodass weniger Server die gestiegene Nachfrage bewältigen mussten.
Zusammengenommen legten diese Faktoren den Fehler während der US-amerikanischen Spitzenlastzeiten offen. Microsoft bestätigte, dass der fehlerhafte Code spezifisch für die Cloud-Gateway-Infrastruktur des Unternehmens war und gewöhnliche Windows-Installationen nicht betraf.
Automatische Wiederherstellung trug den Ausfall über Regionen hinweg
Die Systeme zur Verkehrssteuerung sollten die Verfügbarkeit der Dienste sicherstellen, wenn Server nicht mehr reagierten. Stattdessen leiteten sie Verbindungen auf funktionsfähige Rechner um und erhöhten deren Auslastung, bis auch diese Server auf denselben Fehler stießen. Innerhalb von zwei Stunden hatte sich der Fehler über die gesamte Gateway-Flotte ausgebreitet. Auf dem Höhepunkt reagierten mehr als 80 % der Server nicht mehr.
Auch Schutzmechanismen, die Ausfälle auf separate Infrastrukturpartitionen begrenzen sollten, konnten die Ausbreitung nicht stoppen. Der vorläufige Bericht erklärt nicht vollständig, warum. Teams und SharePoint konnten auf alternative Gateways ausweichen und erholten sich schneller, Exchange Online konnte diesen Wechsel jedoch nicht im erforderlichen Umfang vollziehen. Der Zugriff auf Postfächer und die E-Mail-Zustellung blieben stark beeinträchtigt.
Der Neustart ausgefallener Server brachte kaum Entlastung. Wartender Datenverkehr überlastete sie schnell erneut, während die standardmäßigen Rollback-Mechanismen eine Monate zuvor bereitgestellte Softwareänderung nicht ohne Weiteres rückgängig machen konnten. Die Techniker entwickelten schließlich ein Update, das den zuvor funktionierenden Code wiederherstellte, und schalteten die Servergruppen schrittweise wieder online.
Microsoft hat seitdem die Kapazität erhöht und zusätzliche Überwachungs- sowie Verkehrssteuerungsmechanismen eingeführt. Ein Abschlussbericht mit Einzelheiten zu längerfristigen Korrekturmaßnahmen wird am 20. Nov. erwartet.
Prüfen, ob die Incident Response von Exchange abhängt
Für Sicherheitsteams geht es dabei um mehr als den Verlust des Posteingangzugriffs durch Mitarbeiter. Microsoft nannte Exchange-abhängige Funktionen von Defender und Purview unter den betroffenen Diensten.
Die eigenen Reaktionsverfahren einer Organisation können zusätzliche Abhängigkeiten schaffen. Mit Microsoft Defender XDR können Administratoren E-Mail-Benachrichtigungen für Sicherheitsvorfälle konfigurieren, darunter auch Benachrichtigungen auf Grundlage des Schweregrads einer Warnung. Ein Security Operations Center, das diese Nachrichten an ein Exchange-Online-Postfach weiterleitet, könnte während eines Exchange-Ausfalls Schwierigkeiten haben, sie zu empfangen oder darauf zuzugreifen.
Das ist ein mögliches Ausfallszenario und kein bestätigter Befund, dass dieser Ausfall dazu geführt hat, dass Organisationen Bedrohungen übersehen haben. Erkennung, Zustellung von Benachrichtigungen und Zugriff der Analysten sind separate Phasen; Teams müssen feststellen, welche davon in ihrer Umgebung verfügbar bleibt.
Wenn Ihre Organisation diese Konfiguration verwendet, können drei Prüfungen zeigen, ob ein Exchange-Ausfall Ihre Reaktion unterbrechen würde:
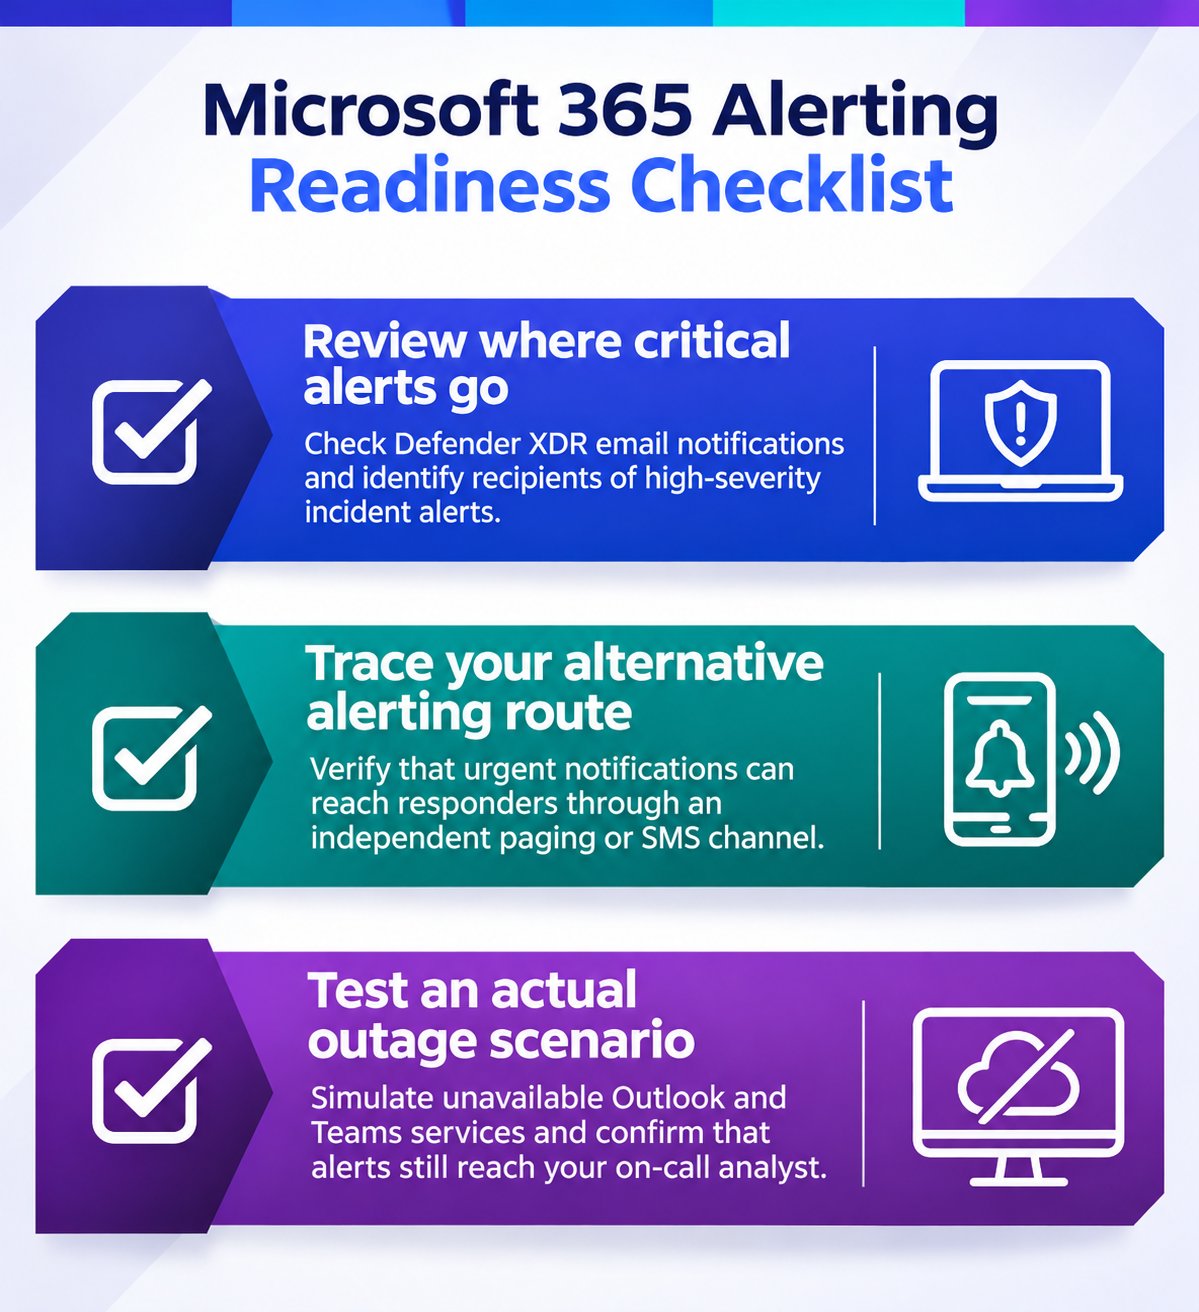
Organisationen, die vom Ausfall im November betroffen waren, sollten außerdem prüfen, ob Kommunikationsausfälle ihre Reaktion auf tatsächliche Vorfälle verzögert haben. Vergleichen Sie die Zeitstempel von Vorfällen in Microsoft Defender XDR mit den Aufzeichnungen zur Zustellung und Bestätigung von Benachrichtigungen aus dem SIEM oder – sofern verfügbar – der Plattform für das Vorfallmanagement.
Nutzen Sie die Nachbesprechung des Vorfalls, um verzögerte Benachrichtigungen, nicht zugängliche Untersuchungstools und bestätigte Überwachungslücken voneinander zu unterscheiden. Aktualisieren Sie den Incident-Response-Plan anhand der festgestellten Ausfälle, weisen Sie Korrekturmaßnahmen zu und testen Sie den Reaktionsprozess nach den Änderungen erneut.
Weiterführende Lektüre: Von verzögerten Bedrohungsuntersuchungen bis zu unterbrochenen Compliance-Prozessen hat der Ausfall von Microsoft mehrere betriebliche Risiken offengelegt. Erfahren Sie, was Sicherheitsteams überprüfen sollten.