

















大規模言語モデルは、セキュリティアラートを数分で調査できる。しかし、企業が生成するすべてのアラートを調べるために利用すれば、相当なコストがかかる可能性がある。
今年初め、Anthropicは動画を公開し、社内のセキュリティチームが、Claudeを使ってセキュリティアラートを調査するCLUE(Claude Looks Up Evidence)というシステムを構築した経緯を説明した。
適切なコンテキストを与えると、Claudeは調査計画を立て、複数のセキュリティツールから証拠を集め、調査結果を相関分析し、既知の悪意ある活動に関連するIPアドレスから認証情報が侵害されたことを特定した。
この特定のシナリオにおける結果は、非常に印象的なものだった。このシステムを使うことで、アナリストが何時間もかけて行っていた作業を数分に凝縮でき、LLMが極めて優れたセキュリティ調査役になったことが証明された。特に、適切な指示を与えた場合にはその能力が際立つ。
しかし、セキュリティ調査プロセスでAIを利用する際の本当の課題は、モデルの能力ではなく、トークノミクスにある。
AI調査のトークノミクス
ここでいうトークノミクスとは、AI推論の経済性、つまりトークンがどのように価格設定され、消費されるか、そして最終的にその消費がどのようにビジネス価値へと結び付くかを指す。
Anthropicのデモで示された調査は、Claudeに単一のプロンプトを送るだけのものではない。ほとんどのエージェント型システムと同様、一連の逐次的なツール呼び出しによって動作する。各ステップでモデルは追加の証拠を集め、それまでに得たすべての情報を基に推論し、次に何を調査するかを決定する。
調査が進むにつれ、繰り返し処理しなければならないコンテキストの量は増え続ける。
Anthropicによると、CLUEは1件の調査につき平均25回のツール呼び出しを行い、SIEMクエリ、脅威インテリジェンスフィード、Slackの会話、社内ドキュメント、コードリポジトリ、その他のセキュリティデータを含む複数のソースからデータを取得する。
1件の調査で最終的に消費されるのは、入力トークン約150万個と出力トークン1万個であり、Anthropicの料金体系でClaude Sonnet 4.6を利用すると、1件あたりおよそ4.65ドルになる。
平均的な大企業は年間約45万件のアラートを受け取るため、このワークフローをその件数に適用すると、アナリスト、セキュリティツール、インフラ、修復対応のコストを考慮する前でも、推論コストだけで年間200万ドルを大きく上回る。
AIを活用した調査ワークフローの多くは、すでに大きな価値を生み出している。したがって問題は、LLMをSOCに導入すべきかどうかではなく、現在のアーキテクチャの経済性が、エンタープライズ規模で包括的な調査を支えられるかどうかだ。
フィルタリングは新しい戦略ではない
すぐに出てくる答えは、すべてのアラートにこのレベルの調査が必要なわけではないため、信頼度の高いアラートだけをLLMに送るべきだというものだ。
しかし、それこそがセキュリティチームがすでに行っている運用である。調査を社内で実施するか、MDRプロバイダーに外部委託するかにかかわらず、ほとんどの組織は重大度の高いアラートを調査し、一部の中程度のアラートを確認し、残りの優先度を下げている。人手の処理能力には常に限界があるからだ。
問題は、攻撃者がその経済性を理解していることだ。Intezerの分析によると、2500万件を超えるアラートのうち、確認されたインシデントのほぼ1%は、当初、重大度が低い、または情報提供目的に分類されたアラートに端を発していた。
この結果は、重大度に基づくフィルタリングの限界を示している。一部の本物の脅威は、比較的重要でないように見えるシグナルから始まる。こうしたアラートの優先度を一貫して下げる組織は、さらなる調査に値するインシデントを見落とすリスクがある。
平均的な大企業では、調査されないアラートの中に、年間50件をわずかに超える本物の脅威が潜んでいることになる。
トークノミクスがすべてのアラートを調査することを支えられない場合、組織は必然的にフィルタリングに戻る。そしてそうなれば、従来と同じトレードオフを受け入れ、機能しない同じSOC運用モデルにとどまることになる。
仕事ごとに異なるAI
Anthropicのデモは、SOC内でLLMが最大の価値を生み出す領域を明確に示している。複雑な調査では、推論能力と複数のソースから得た証拠を統合する能力が役立つ。
アラートのトリアージは、別種の問題だ。数十万件に及ぶアラートについて、一貫した証拠収集、フォレンジック分析、判定を、網羅的な対応が現実的になるコストで実施する必要がある。こうした要件には、アナリスト主導の深い調査に使うものとは異なるAIアーキテクチャが求められる。
下層にハードウェア、中間にOS、最上層にアプリケーションがある一般的なコンピューティングスタックを思い浮かべてほしい。AI SOCでは、検知ツールがアラートを生成し、自動調査レイヤーがエスカレーションに値するアラートを判断し、その上に配置されたClaudeのような推論モデルが、対応を必要とする比較的少数のアラートを分析する。
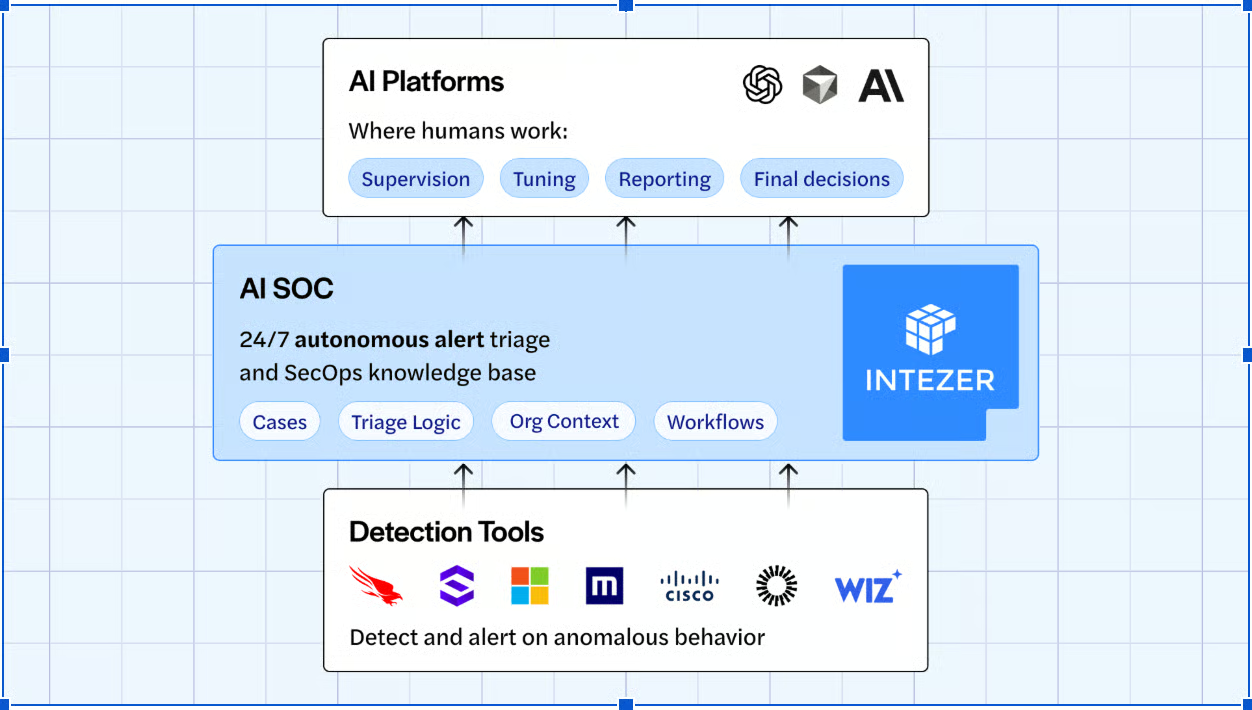
アプリケーションがその上で動作するOSに取って代わるものではないのと同様に、LLMがAI SOCの調査レイヤーに取って代わることもない。証拠をすでに収集し、調査結果を相関分析し、人間のような推論を本当に必要とするアラートを特定したシステムの上に構築されてこそ、LLMはより効果的になる。
大規模な調査と深い推論を組織が効果的に分離するほど、両方のレイヤーの価値は高まり、トークン効率も向上する。
セキュリティチームが次に取り組むべきことは、LLMが調査できるアラートの数を単に把握することではない。各調査にかかるコストと、さまざまなアプローチが本物の脅威をどれだけ確実に特定できるかを測定することだ。
つまり、アラート1件あたりのコスト、調査の精度、偽陰性率、エスカレーションの質、そして削減できたアナリストの作業時間を比較する必要がある。多層型AIアーキテクチャは、より持続可能な道筋になる可能性がある。しかし、その価値は最終的に、重要な脅威を見逃さない能力を損なうことなく、調査対象の範囲を広げられるかどうかにかかっている。
別のニュース:ハッカーはYobaマルウェアを拡散――GitHubでホストされた偽のChatGPTとClaudeのダウンロード