

















Les grands modèles de langage peuvent enquêter sur des alertes de sécurité en quelques minutes. Mais les utiliser pour examiner chaque alerte générée par une entreprise pourrait coûter très cher.
Plus tôt cette année, Anthropic a publié une vidéo détaillant la manière dont son équipe de sécurité interne a créé un système appelé CLUE (Claude Looks Up Evidence), qui utilise Claude pour enquêter sur les alertes de sécurité.
Avec le contexte adéquat, Claude a élaboré un plan d’enquête, recueilli des éléments auprès de plusieurs outils de sécurité, corrélé les résultats et identifié une compromission de comptes provenant d’une adresse IP associée à une activité malveillante connue.
Les résultats étaient particulièrement impressionnants dans ce scénario. Grâce à ce système, l’équipe a pu condenser plusieurs heures de travail d’analyste en quelques minutes, démontrant que les LLM sont devenus des enquêteurs de sécurité remarquablement performants, surtout lorsqu’ils sont correctement orientés.
Mais le véritable défi de l’utilisation de l’IA dans le processus d’enquête de sécurité n’est pas la capacité des modèles : c’est la tokenomics.
La tokenomics des enquêtes menées par l’IA
Dans ce contexte, la tokenomics désigne l’économie de l’inférence par IA, autrement dit la manière dont les tokens sont tarifés et consommés, et, au bout du compte, la façon dont cette consommation se traduit en valeur pour l’entreprise.
L’enquête présentée dans la démonstration d’Anthropic ne se résume pas à l’envoi d’une seule invite à Claude. Comme la plupart des systèmes agentiques, elle fonctionne au moyen d’une série d’appels séquentiels à des outils. À chaque étape, le modèle recueille des éléments supplémentaires, raisonne à partir de tout ce qu’il a appris jusque-là et décide de ce qu’il doit examiner ensuite.
À mesure que l’enquête progresse, la quantité de contexte qu’il doit traiter à répétition continue d’augmenter.
Selon Anthropic, CLUE effectue en moyenne 25 appels à des outils pour une seule enquête, en récupérant des données auprès de plusieurs sources, notamment des requêtes SIEM, des flux de renseignement sur les menaces, des conversations Slack, de la documentation interne, des dépôts de code et d’autres données de sécurité.
Chaque enquête consomme finalement environ 1,5 million de tokens d’entrée et 10 000 tokens de sortie et, en utilisant la tarification d’Anthropic pour Claude Sonnet 4.6, revient à environ 4,65 dollars US par enquête.
Une grande entreprise moyenne reçoit environ 450 000 alertes par an. Appliquer ce processus à un tel volume d’alertes coûterait donc largement plus de 2 millions de dollars US par an en seuls coûts d’inférence, avant même de prendre en compte les analystes, les outils de sécurité, l’infrastructure ou la remédiation.
De nombreux processus d’enquête assistés par l’IA produisent déjà une valeur considérable, si bien que la question n’est pas de savoir si les LLM ont leur place dans le SOC, mais si l’économie des architectures actuelles permet de mener des enquêtes exhaustives à l’échelle de l’entreprise.
Pourquoi le filtrage n’est pas une stratégie nouvelle
La réponse immédiate consiste à dire que toutes les alertes ne nécessitent pas ce niveau d’enquête et que seules les alertes présentant un haut degré de confiance devraient être transmises au LLM.
Mais c’est exactement ainsi que les équipes de sécurité fonctionnent déjà. Que les enquêtes soient menées en interne ou confiées à un fournisseur de MDR, la plupart des organisations examinent les alertes de gravité élevée, passent en revue certaines alertes de gravité moyenne et relèguent les autres au second plan, car les capacités humaines ont toujours été limitées.
Le problème, c’est que les attaquants comprennent cette logique économique. L’analyse d’Intezer portant sur plus de 25 millions d’alertes a révélé que près de 1 % des incidents confirmés provenaient d’alertes initialement classées comme étant de faible gravité ou informatives.
Cette conclusion illustre une limite du filtrage fondé sur la gravité : certaines menaces réelles commencent par des signaux qui semblent relativement insignifiants. Les organisations qui relèguent systématiquement ces alertes au second plan risquent de passer à côté d’incidents nécessitant une enquête plus approfondie.
Pour une grande entreprise moyenne, cela représente un peu plus de 50 menaces réelles par an dissimulées dans les alertes qui ne font pas l’objet d’une enquête.
Lorsque la tokenomics ne permet pas d’enquêter sur chaque alerte, les organisations finissent inévitablement par recourir au filtrage. Et dès lors, elles opèrent les mêmes arbitrages qu’auparavant et restent prisonnières du même modèle de fonctionnement du SOC, qui ne donne pas de résultats.
Une IA différente pour chaque tâche
La démonstration d’Anthropic montre clairement où les LLM créent le plus de valeur au sein d’un SOC. Les enquêtes complexes bénéficient de leurs capacités de raisonnement et de synthèse des éléments provenant de plusieurs sources.
Le triage des alertes est un problème d’une autre nature. Il exige de recueillir systématiquement les éléments, de réaliser des analyses forensiques et de rendre des verdicts sur des centaines de milliers d’alertes, à un coût qui rende possible une couverture complète. Ces exigences appellent une architecture d’IA différente de celle utilisée pour les enquêtes approfondies menées par les analystes.
Imaginez une pile informatique classique, avec le matériel à la base, le système d’exploitation au milieu et les applications au sommet. Dans un SOC dopé à l’IA, les outils de détection génèrent des alertes, la couche d’enquête automatisée détermine lesquelles justifient une escalade et des modèles de raisonnement comme Claude se placent au sommet pour analyser le nombre relativement limité d’alertes qui le nécessitent.
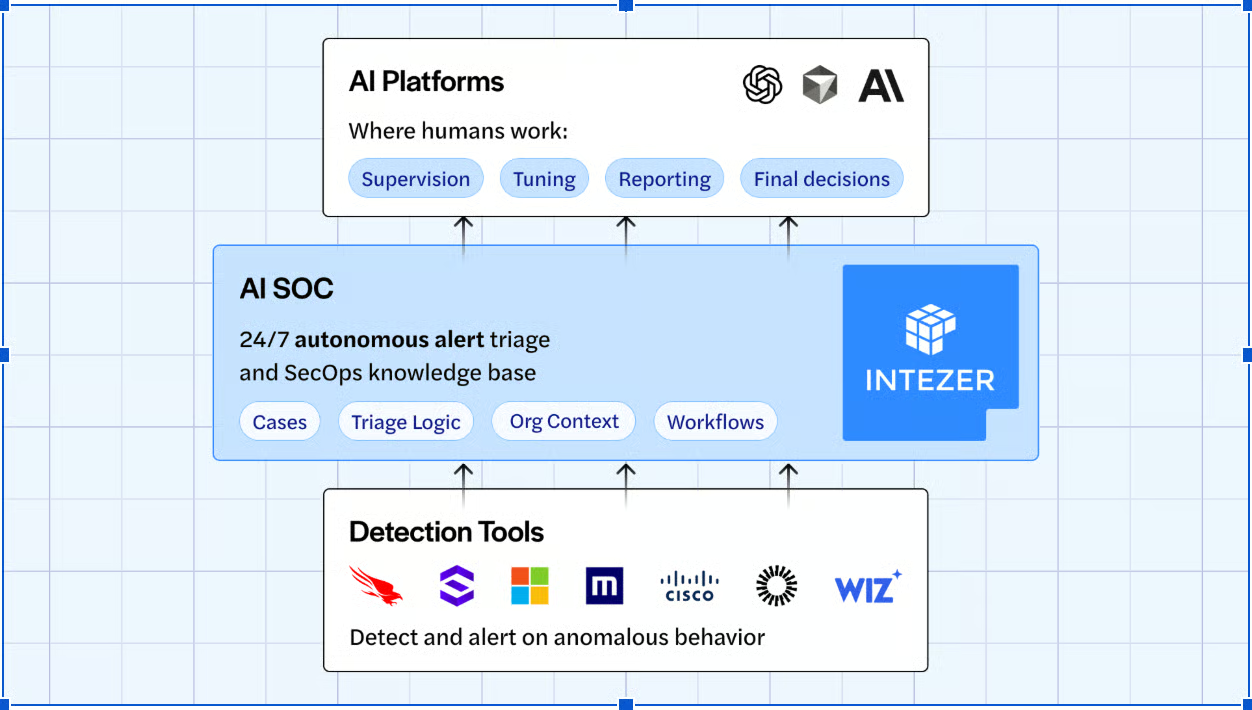
De même que les applications ne remplacent pas le système d’exploitation sur lequel elles s’exécutent, les LLM ne remplaceront pas la couche d’enquête du SOC dopé à l’IA. Ils gagneront en efficacité lorsqu’ils seront construits sur un système ayant déjà recueilli les éléments, corrélé les résultats et identifié les alertes qui nécessitent véritablement un raisonnement comparable à celui d’un humain.
Plus les organisations séparent efficacement les enquêtes à grande échelle du raisonnement approfondi, plus les deux couches gagnent en valeur, tout en optimisant l’utilisation des tokens.
La prochaine étape pour les équipes de sécurité ne consiste pas simplement à déterminer combien d’alertes un LLM peut examiner, mais à mesurer le coût de chaque enquête et la fiabilité avec laquelle les différentes approches identifient les menaces réelles.
Cela signifie comparer le coût par alerte, la précision des enquêtes, les taux de faux négatifs, la qualité des escalades et le temps d’analyste économisé. Une architecture d’IA en couches pourrait offrir une voie plus durable, mais sa valeur dépendra en définitive de sa capacité à étendre la couverture des enquêtes sans compromettre l’aptitude à détecter les menaces qui comptent.
Autre actualité : des hackers diffusent le malware Yoba via de fausses versions téléchargeables de ChatGPT et Claude hébergées sur GitHub