

















Large Language Models können Sicherheitswarnungen innerhalb weniger Minuten untersuchen. Doch sie zur Untersuchung jeder Warnung einzusetzen, die ein Unternehmen erzeugt, könnte einen erheblichen Preis haben.
Anfang dieses Jahres veröffentlichte Anthropic ein Video mit einer detaillierten Darstellung, wie das interne Sicherheitsteam ein System namens CLUE (Claude Looks Up Evidence) entwickelte, das Claude zur Untersuchung von Sicherheitswarnungen einsetzt.
Mit dem richtigen Kontext entwickelte Claude einen Untersuchungsplan, sammelte Belege aus mehreren Sicherheitstools, korrelierte die Ergebnisse und identifizierte einen kompromittierten Zugang, der von einer IP-Adresse mit bekannter bösartiger Aktivität ausging.
Die Ergebnisse waren in diesem speziellen Szenario äußerst beeindruckend. Mit diesem System konnten sie die Arbeit von Analysten, die sonst Stunden gedauert hätte, auf wenige Minuten verkürzen. Damit bewiesen sie, dass LLMs bemerkenswert leistungsfähige Sicherheitsermittler geworden sind – insbesondere, wenn sie gezielt eingesetzt werden.
Die eigentliche Herausforderung beim Einsatz von KI im Sicherheitsuntersuchungsprozess ist jedoch nicht die Leistungsfähigkeit des Modells, sondern die Tokenomics.
Die Tokenomics von KI-Untersuchungen
In diesem Zusammenhang bezeichnet Tokenomics die Ökonomie der KI-Inferenz – also, wie Tokens bepreist und verbraucht werden und wie sich dieser Verbrauch letztlich in geschäftlichen Nutzen übersetzt.
Die in der Anthropic-Demonstration gezeigte Untersuchung besteht nicht einfach aus einem einzelnen an Claude gesendeten Prompt. Wie die meisten agentischen Systeme arbeitet sie eine Reihe sequenzieller Tool-Aufrufe ab. Bei jedem Schritt sammelt das Modell weitere Belege, wertet alles bisher Gelernte aus und entscheidet, was als Nächstes untersucht werden soll.
Im Verlauf der Untersuchung wächst die Menge an Kontext, die wiederholt verarbeitet werden muss, kontinuierlich.
Laut Anthropic, führt CLUE durchschnittlich 25 Tool-Aufrufe pro Untersuchung durch und ruft Daten aus mehreren Quellen ab, darunter SIEM-Abfragen, Threat-Intelligence-Feeds, Slack-Unterhaltungen, interne Dokumentation, Code-Repositories und andere Sicherheitsdaten.
Jede Untersuchung verbraucht letztlich etwa 1,5 Millionen Eingabe-Tokens und 10.000 Ausgabe-Tokens. Unter Verwendung der Preisgestaltung von Anthropic für Claude Sonnet 4.6 ergibt das ungefähr 4,65 US-Dollar pro Untersuchung.
Das durchschnittliche Großunternehmen erhält jährlich etwa 450.000 Warnungen. Würde dieser Workflow auf dieses Warnungsvolumen angewendet, würden allein für die Inferenzkosten deutlich mehr als 2 Millionen US-Dollar pro Jahr anfallen – noch ohne Analysten, Sicherheitstools, Infrastruktur oder Behebung einzurechnen.
Viele KI-gestützte Untersuchungs-Workflows liefern bereits heute erheblichen Nutzen. Die Frage ist daher nicht, ob LLMs in ein SOC gehören, sondern ob die Wirtschaftlichkeit heutiger Architekturen umfassende Untersuchungen im Unternehmensmaßstab ermöglicht.
Warum Filtern keine neue Strategie ist
Die unmittelbare Antwort lautet, dass nicht jede Warnung eine Untersuchung auf diesem Niveau erfordert und daher nur Warnungen mit hoher Konfidenz an das LLM gesendet werden sollten.
Doch genau so arbeiten Sicherheitsteams bereits. Unabhängig davon, ob Untersuchungen intern durchgeführt oder an einen MDR-Anbieter ausgelagert werden, untersuchen die meisten Unternehmen Warnungen mit hoher Schwere, prüfen einige Warnungen mittlerer Schwere und stufen den Rest zurück, weil die menschlichen Kapazitäten schon immer begrenzt waren.
Das Problem ist, dass Angreifer diese wirtschaftlichen Zusammenhänge verstehen. Die Analyse von Intezer zu mehr als 25 Millionen Warnungen ergab, dass nahezu 1 % der bestätigten Vorfälle von Warnungen ausgingen, die ursprünglich als von geringer Schwere oder als informativ eingestuft worden waren.
Dieses Ergebnis verdeutlicht eine Einschränkung der Filterung nach Schweregrad: Einige echte Bedrohungen beginnen mit Signalen, die vergleichsweise unbedeutend erscheinen. Unternehmen, die solche Warnungen konsequent zurückstufen, riskieren, Vorfälle zu übersehen, die eine weitere Untersuchung rechtfertigen.
Für das durchschnittliche Großunternehmen entspricht das etwas mehr als 50 echten Bedrohungen pro Jahr, die sich in den nicht untersuchten Warnungen verstecken.
Wenn die Tokenomics die Untersuchung jeder Warnung nicht zulassen, greifen Unternehmen zwangsläufig auf Filterung zurück. Und sobald das geschieht, treffen sie dieselben Abwägungen wie schon immer und bleiben in demselben SOC-Betriebsmodell gefangen, das nicht funktioniert.
Unterschiedliche KI für unterschiedliche Aufgaben
Die Demonstration von Anthropic zeigt deutlich, wo LLMs innerhalb eines SOC den größten Nutzen schaffen. Komplexe Untersuchungen profitieren von Schlussfolgerungen und der Fähigkeit, Belege aus mehreren Quellen zusammenzuführen.
Die Triage von Warnungen ist eine andere Art von Problem. Sie erfordert eine konsistente Beweiserhebung, forensische Analyse und Beurteilungen für Hunderttausende von Warnungen – und das zu Kosten, die eine vollständige Abdeckung praktikabel machen. Diese Anforderungen verlangen eine andere KI-Architektur als die für tiefgehende, von Analysten geleitete Untersuchungen.
Man kann sich das wie jeden Computing-Stack vorstellen: unten die Hardware, in der Mitte das Betriebssystem und oben die Anwendungen. In einem KI-SOC Erkennungstools erzeugen Warnungen, die automatisierte Untersuchungsebene entscheidet, welche Warnungen eine Eskalation rechtfertigen, und Schlussfolgerungsmodelle wie Claude sitzen darüber, um die vergleichsweise wenigen Warnungen zu analysieren, bei denen dies erforderlich ist.
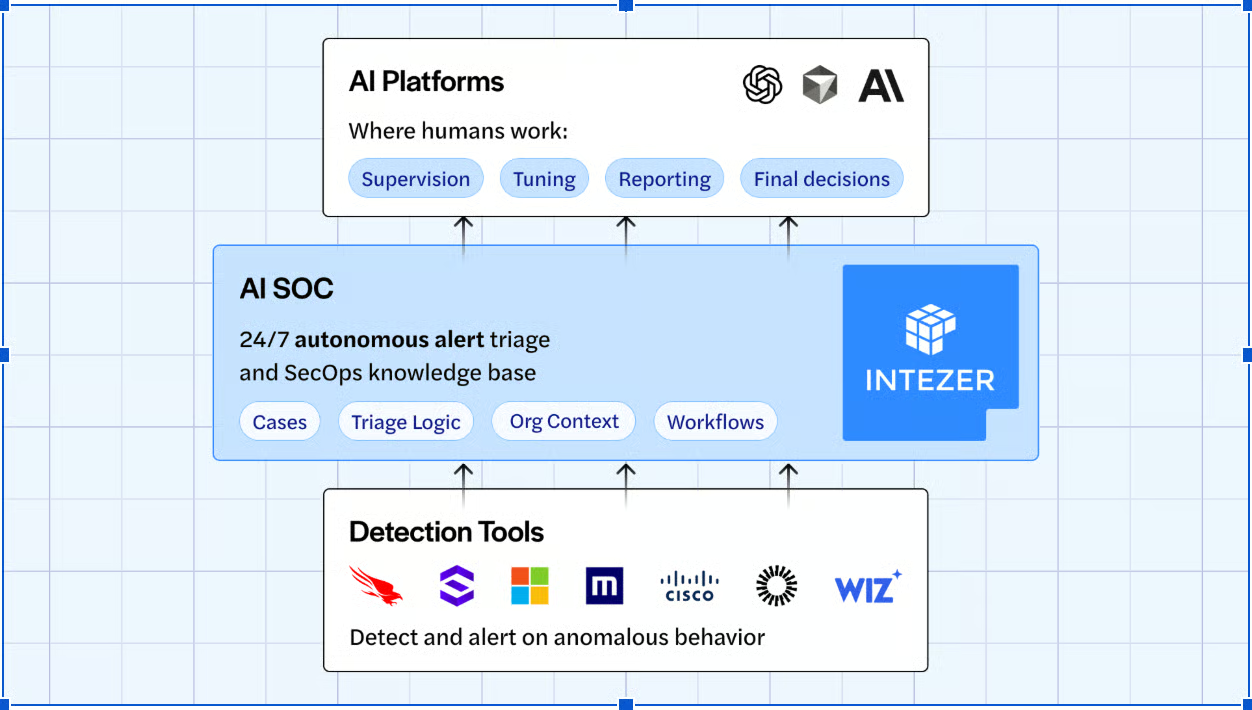
So wie Anwendungen das Betriebssystem, auf dem sie laufen, nicht ersetzen, werden LLMs auch nicht die Untersuchungsebene des KI-SOC ersetzen. Sie werden effektiver, wenn sie auf einem System aufbauen, das bereits Belege gesammelt, Ergebnisse korreliert und die Warnungen identifiziert hat, die tatsächlich menschenähnliche Schlussfolgerungen erfordern.
Je effektiver Unternehmen groß angelegte Untersuchungen von tiefgehenden Schlussfolgerungen trennen, desto wertvoller werden beide Ebenen – und desto effizienter gehen sie zugleich mit Tokens um.
Der nächste Schritt für Sicherheitsteams besteht nicht einfach darin, zu ermitteln, wie viele Warnungen ein LLM untersuchen kann, sondern zu messen, was jede Untersuchung kostet und wie zuverlässig verschiedene Ansätze echte Bedrohungen identifizieren.
Das bedeutet, die Kosten pro Warnung, die Genauigkeit der Untersuchung, die Rate falsch-negativer Ergebnisse, die Qualität der Eskalation und die eingesparte Zeit von Analysten zu vergleichen. Eine mehrschichtige KI-Architektur könnte einen nachhaltigeren Weg bieten. Ihr Wert wird letztlich jedoch davon abhängen, ob sie die Untersuchungsabdeckung erweitert, ohne die Fähigkeit zu beeinträchtigen, relevante Bedrohungen zu erkennen.
Außerdem: Hacker verbreiten Yoba-Malware über gefälschte, auf GitHub gehostete Downloads von ChatGPT und Claude